Je m’appelle Johannes Eva et je crée des sites web depuis 27 ans. Le Baromètre est né d’un manque : aucun classement existant ne mesurait ce qui m’intéressait, la qualité d’écriture des modèles d’IA en français.
Les benchmarks publics privilégient le code, les mathématiques et le raisonnement. Le peu qu’ils consacrent à l’écriture est presque toujours jugé en anglais. Ici, seule compte la qualité des textes générés. Les consignes sont pensées directement en français et les réponses sont comparées à l’aveugle.
Une place particulière revient aux modèles qu’on peut faire tourner chez soi. Les familles Gemma 4, Qwen 3.6 et 3.8, Ling 3.0 Flash, Muse Glimmer ou Granite 4.2, entre autres, sont signalées par 🏠. Elles ont été exécutées localement, dans plusieurs quantifications, raisonnement activé et désactivé.
Ce site est un projet personnel. Je ne suis payé par aucun éditeur de modèles et je n’ai aucun intérêt à en favoriser un.
Les machines utilisées pour les modèles locaux
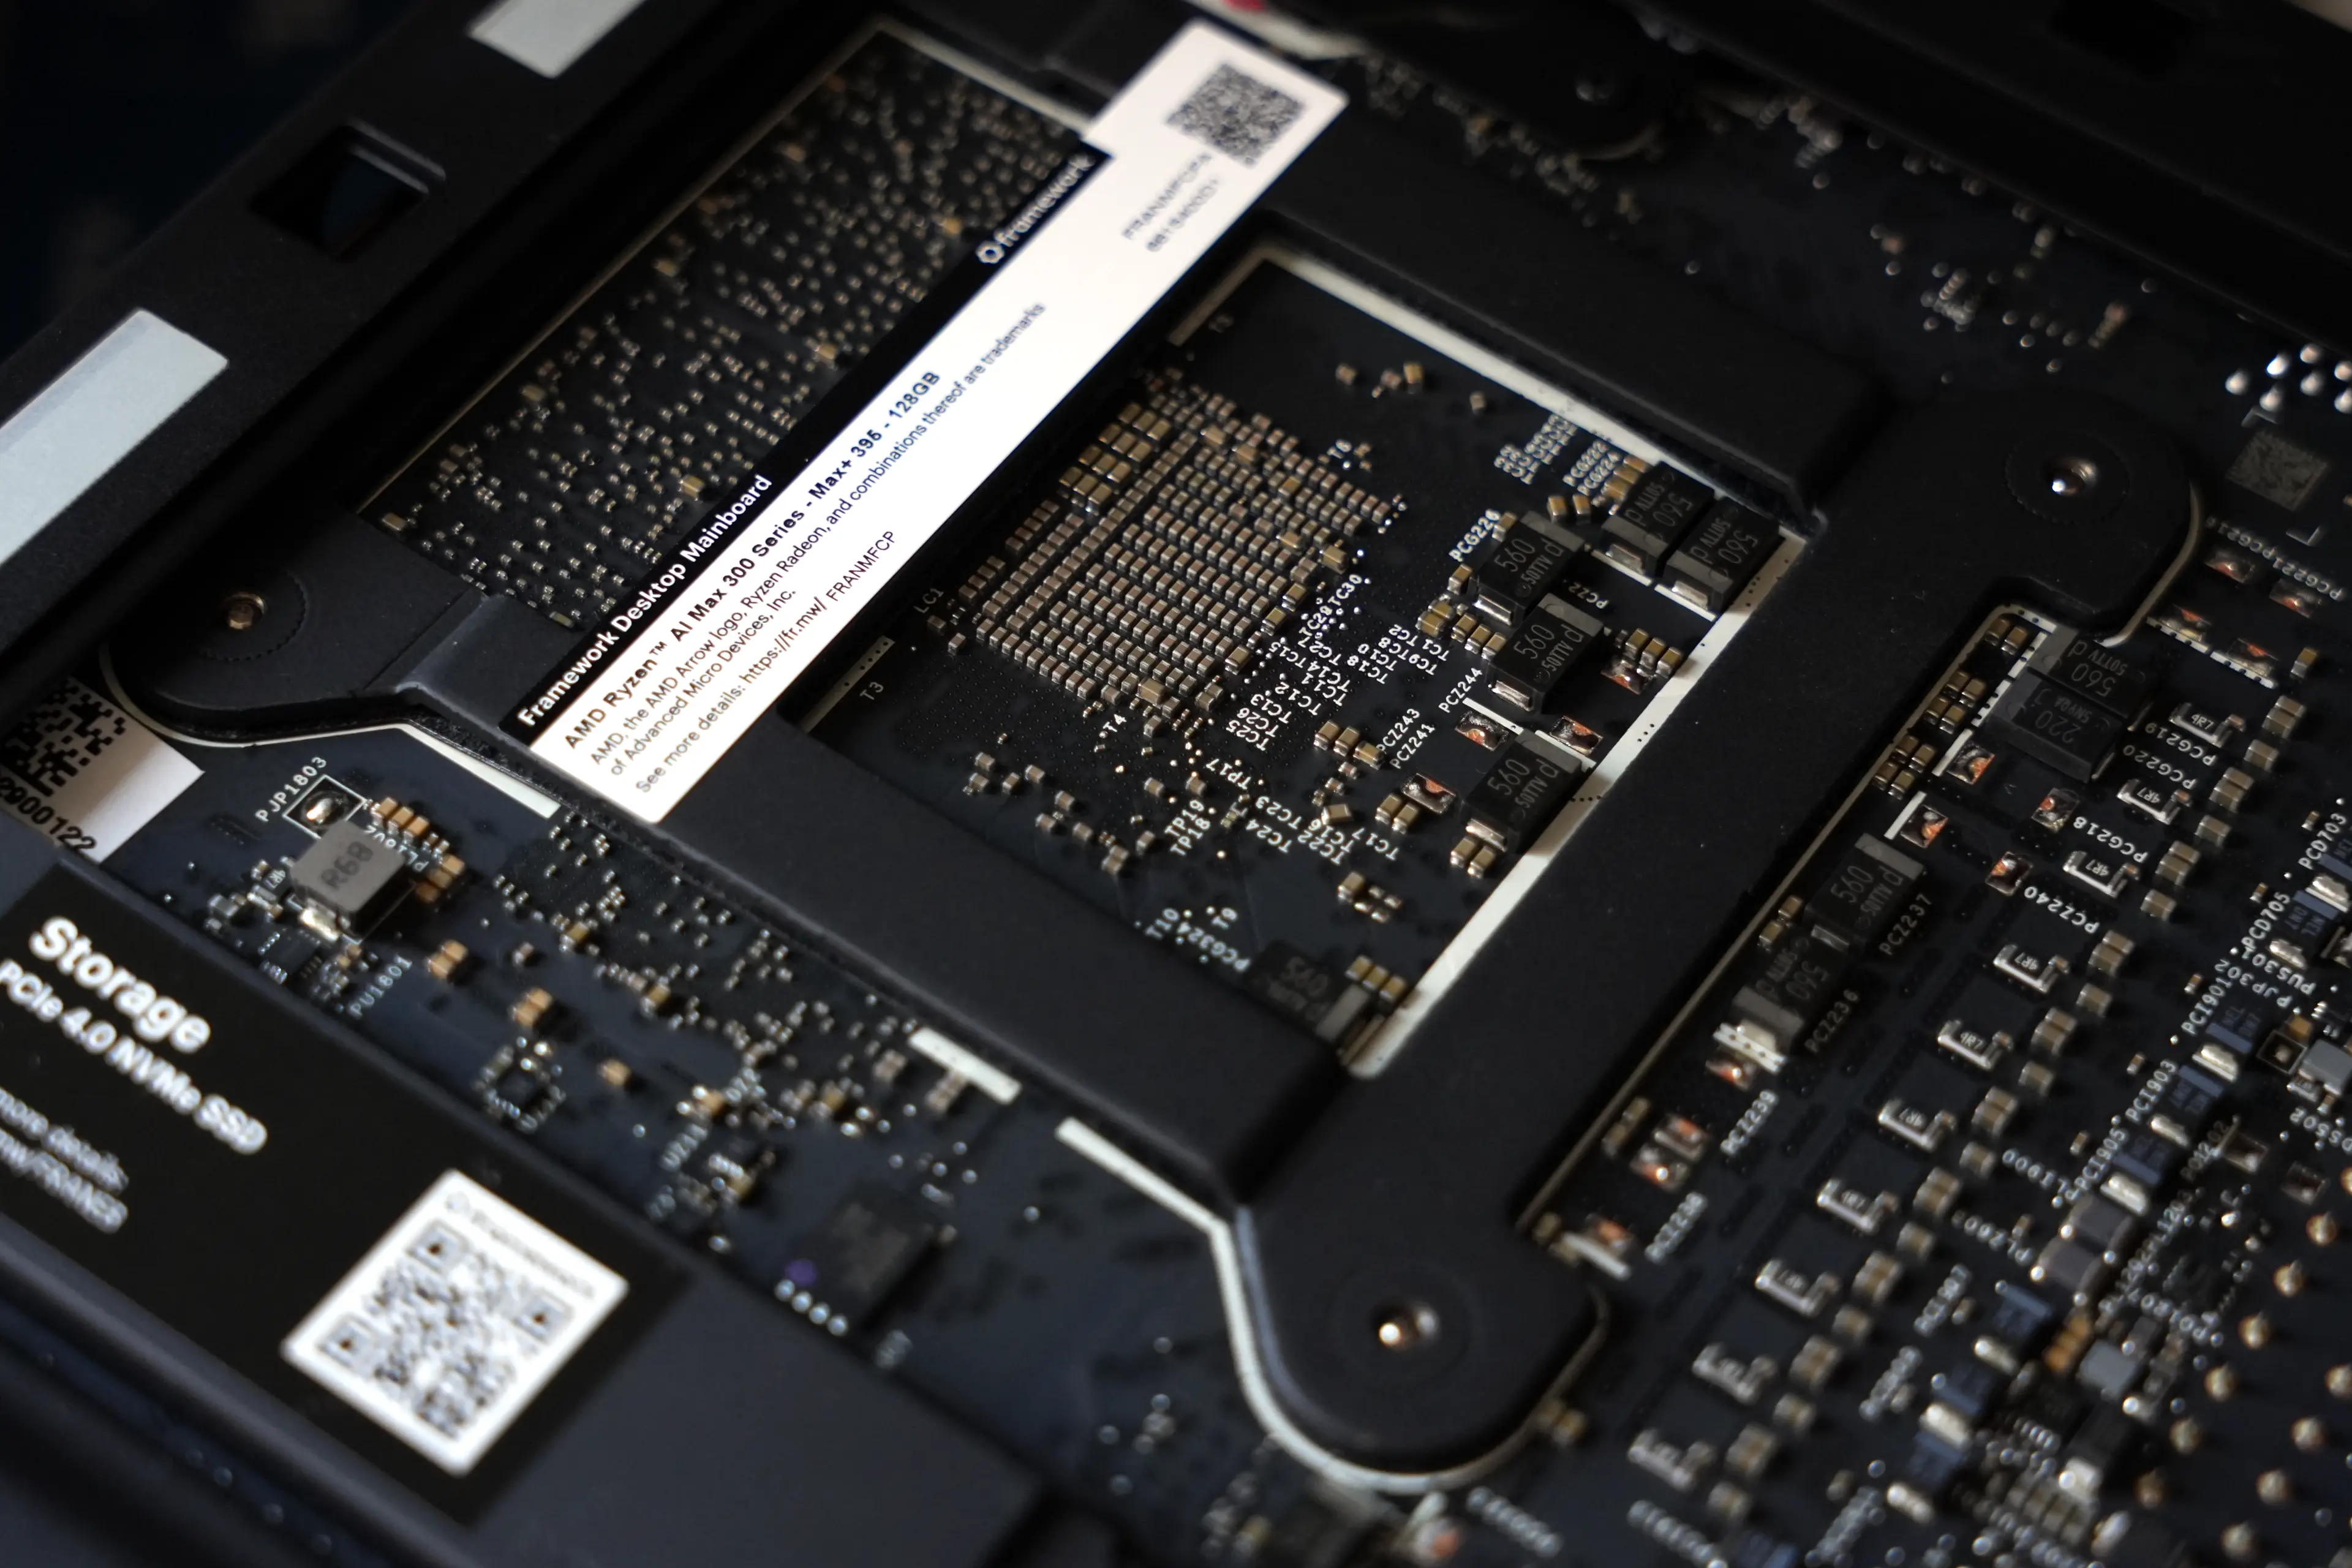
- Ordinateur
- Framework Desktop, AMD Ryzen AI Max série 300, révision A6
- Processeur
- AMD Ryzen AI Max+ 395, 16 cœurs et 32 threads, jusqu’à 5,19 GHz
- Partie graphique
- AMD Radeon 8060S intégrée
- Mémoire
- 128 Go de mémoire unifiée, partagée entre le processeur et la partie graphique
Les modèles locaux sont exécutés sur un Framework Desktop équipé d’un AMD Ryzen AI Max+ 395. Ses 128 Go de mémoire unifiée sont accessibles au processeur comme à la partie graphique, ce qui permet de charger des modèles plus volumineux que sur la plupart des cartes graphiques grand public. Une seconde machine dotée d’une NVIDIA GeForce RTX 5070 Ti contribue les modèles les plus légers.
Vitesse de génération observée en local (Strix Halo)
Médiane des tokens générés par seconde sur la machine Strix Halo (Framework Desktop, Ryzen AI Max+ 395), calculée sur les réponses valides du benchmark générées sur celle-ci, tokens de raisonnement compris. La vitesse varie selon la longueur du contexte et le logiciel. Les modèles sans suffisamment de mesures sur Strix Halo ne sont pas listés.
| Modèle | Quantification | Vitesse médiane | Réponses |
|---|---|---|---|
| Gemma 4 26B A4B | Q8_0 | 39.8 tokens/s | 465 |
| Gemma 4 E2B | Q4_K_M | 39.4 tokens/s | 224 |
| Gemma 4 E4B | Q8_0 | 35.9 tokens/s | 542 |
| Gemma 4 E2B | Q6_K | 33.2 tokens/s | 216 |
| Ling 3.0 Flash | Q4_K_M | 31.6 tokens/s | 277 |
| Ling 3.0 Flash | Q4_K_M | 30.5 tokens/s | 240 |
| Gemma 4 E2B | Q8_0 | 29.2 tokens/s | 224 |
| Gemma 4 26B A4B QAT | QAT-Q4_0 | 27.9 tokens/s | 118 |
| Qwen3.6 35B A3B | Q4_K_M | 26.6 tokens/s | 347 |
| Nemotron 3 Nano Omni | Q4_K_M | 25.1 tokens/s | 960 |
| Gemma 4 E4B | Q4_K_M | 22.4 tokens/s | 221 |
| Qwen3.6 35B A3B | Q8_0 | 22.1 tokens/s | 312 |
| Nemotron 3 Nano Omni | Q8_0 | 21.2 tokens/s | 391 |
| Nemotron 3 Super | Q4_K_M | 21.1 tokens/s | 413 |
| Gemma 4 26B A4B | Q6_K | 20.2 tokens/s | 539 |
| Gemma 4 E4B | Q6_K | 18.6 tokens/s | 218 |
| Granite 4.2 8B | Q4_K_M | 16.9 tokens/s | 36 |
| Gemma 4 12B | Q8_0 | 14.6 tokens/s | 124 |
| Gemma 4 12B QAT | QAT-Q4_0 | 11 tokens/s | 752 |
| Gemma 4 31B QAT | QAT-Q4_0 | 10 tokens/s | 548 |
| Gemma 4 12B | Q6_K | 9 tokens/s | 216 |
| Qwen3.8 27B | Q4_K_M | 8.9 tokens/s | 546 |
| Muse Glimmer 30B Kquant 17gb | K-Quant 17GB | 8.8 tokens/s | 394 |
| Qwen3.8 27B | Q8_0 | 8.4 tokens/s | 498 |
| Muse Glimmer 30B Kquant Dynamic | K-Quant Dynamic | 8 tokens/s | 397 |
| Granite 4.2 30B | Q4_K_M | 7.6 tokens/s | 423 |
| Qwen3.6 27B | Q8_0 | 7.5 tokens/s | 190 |
| Qwen3.8 27B | Q6_K | 7 tokens/s | 504 |
| Granite 4.2 30B | Q6_K | 6.6 tokens/s | 397 |
| Gemma 4 31B | Q6_K | 5.8 tokens/s | 527 |
| Qwen3.6 27B | Q4_K_M | 5.2 tokens/s | 588 |
| Granite 4.2 30B | Q8_0 | 4.9 tokens/s | 447 |
| Gemma 4 31B | Q8_0 | 4.8 tokens/s | 316 |