Le classement complet
Tous les modèles classés sur l’écriture en français, avec des filtres par type de texte, éditeur, taille, raisonnement et quantification, et les matrices de duels.
Les nouveaux modèles à leur entrée dans le classement, leur place face à leur prédécesseur, les nouvelles analyses et les grandes étapes du Baromètre.
120 941 verdicts classés
120 modèles classés
encore 4 059 avant 125 000
Totaux cumulés de l’édition française, jour par jour.
Rangs et scores sont ceux d’aujourd’hui : ils sont recalculés à chaque nouveau verdict, pas figés à l’arrivée du modèle.

Claude Fable 5.2. Aujourd’hui 7e sur 120, avec un score de 95,5. Soit 1,0 point de moins que son prédécesseur, Claude Fable 5.1 (4e, 96,5).

Gemini 4 Hydrogen. Aujourd’hui 13e sur 120, avec un score de 89,8.

Qwen4 Max. Aujourd’hui 23e sur 120, avec un score de 83,0. Soit 10,6 points de plus que son prédécesseur, Qwen3.8 Max (31e, 72,4).

Flint V1.0. Aujourd’hui 108e sur 120, avec un score de 7,6.

Ling 3.2 Flash. Aujourd’hui 48e sur 120, avec un score de 62,3.

Muse Ember. Aujourd’hui 27e sur 120, avec un score de 77,0.
Kimi K3.1 Pro. Aujourd’hui 17e sur 120, avec un score de 87,3. Soit 4,6 points de moins que son prédécesseur, Kimi K3 (12e, 91,9). Duels directs remportés contre lui : 6 sur 13 (46 %).

GPT-6.1 Terra. Aujourd’hui 11e sur 120, avec un score de 92,4. Soit 17,1 points de plus que son prédécesseur, GPT-5.6 Terra (28e, 75,3).

Mercury 3. Aujourd’hui 49e sur 120, avec un score de 61,5.

Beam 1.0. Aujourd’hui 33e sur 120, avec un score de 70,2.
Gemini 4 Argon. Aujourd’hui 25e sur 120, avec un score de 77,5.

MiniMax M3.1 Flash. Aujourd’hui 114e sur 120, avec un score de 5,1.
Nemotron 3.5 Super VL. Aujourd’hui 32e sur 120, avec un score de 71,4.

Step 5 Preview. Aujourd’hui 63e sur 120, avec un score de 47,8.
100 000
Atteint 86 jours après le premier duel, 16 jours après le palier de 75 000.
Ling 3.1 Flash. Aujourd’hui 30e sur 120, avec un score de 73,7.

Mistral Large 4. Aujourd’hui 57e sur 120, avec un score de 53,3.
Nemotron 3 Ultra. Aujourd’hui 46e sur 120, avec un score de 65,4.
Nemotron 3.5 Lightning. Aujourd’hui 95e sur 120, avec un score de 17,9.
Claude Haiku 5.5. Aujourd’hui 37e sur 120, avec un score de 69,4.
Jusqu’ici, la plupart des duels comparaient des messages personnels. Les nouveaux duels se répartissent entre les dix catégories (lettres, articles, fiction, discours, rapports…), en commençant par les moins couvertes : le classement reflétera peu à peu tous les types de textes.
Muse Spark 1.3, qui reculait au classement, ne juge plus ; ses verdicts passés restent publiés. Claude Opus 5.5 reprend sa part, et les duels arrivent au même rythme.
Dans le Duel et les face-à-face, les réponses montrent désormais leurs passages en gras, leurs intertitres et leurs listes au lieu d’astérisques et de dièses bruts : on juge le texte tel qu’un lecteur le verrait.
Environ un verdict sur vingt venait d’un juge face à son propre modèle, qui avait tendance à se favoriser : jusqu’à cinq points pour certains modèles. Ces verdicts restent publiés sur la page des juges mais n’entrent plus dans le classement, et aucun juge ne reçoit plus son propre modèle.
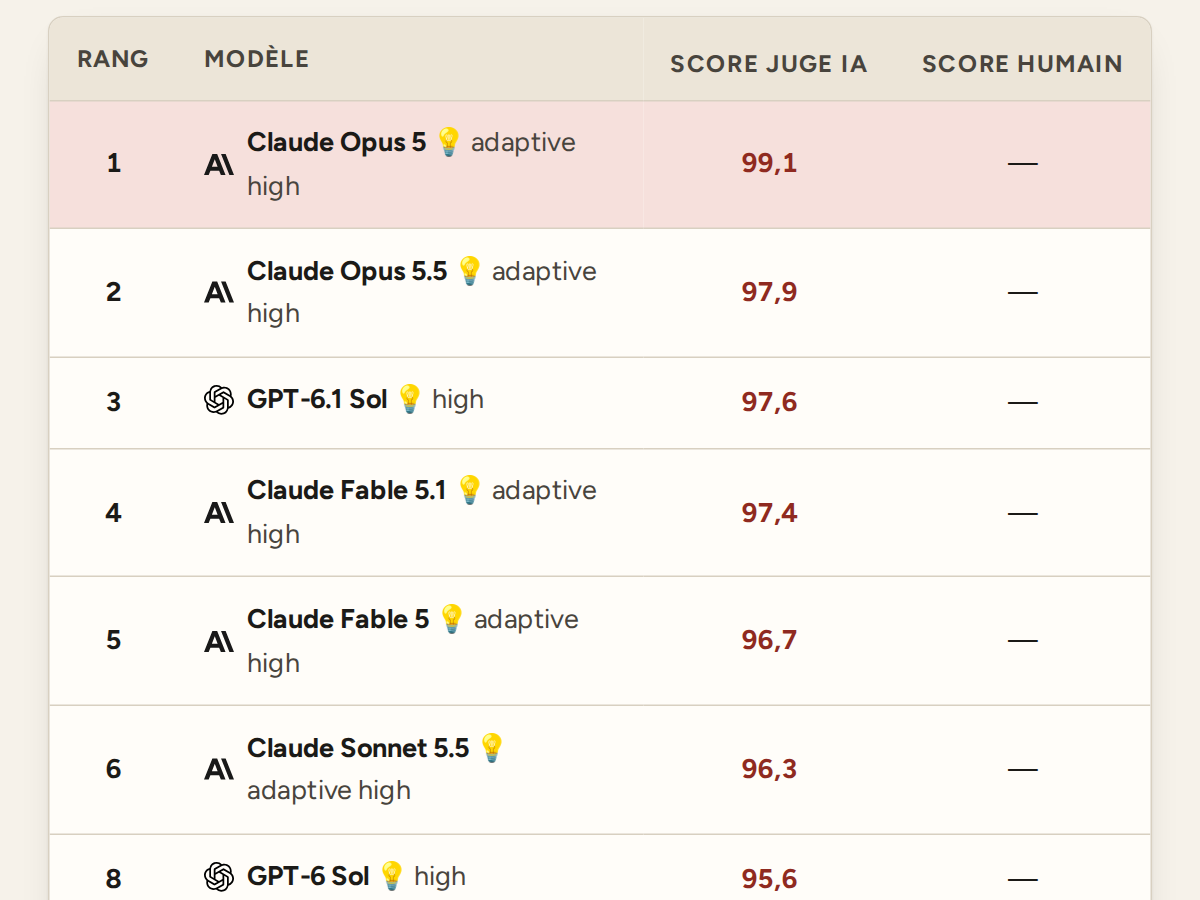
GPT-6.1 Sol. Aujourd’hui 2e sur 120, avec un score de 97,2. Soit 2,0 points de plus que son prédécesseur, GPT-6 Sol (9e, 95,2). Duels directs remportés contre lui : 16 sur 21 (76 %).
100
Avec Aion 3.5, 73 jours après le premier duel.

Aion 3.5. Aujourd’hui 26e sur 120, avec un score de 77,4. Soit 25,1 points de plus que son prédécesseur, Aion 3.0 (58e, 52,3).
Claude Sonnet 5.5. Aujourd’hui 9e sur 120, avec un score de 95,2. Soit 5,7 points de plus que son prédécesseur, Claude Sonnet 5 (14e, 89,5).
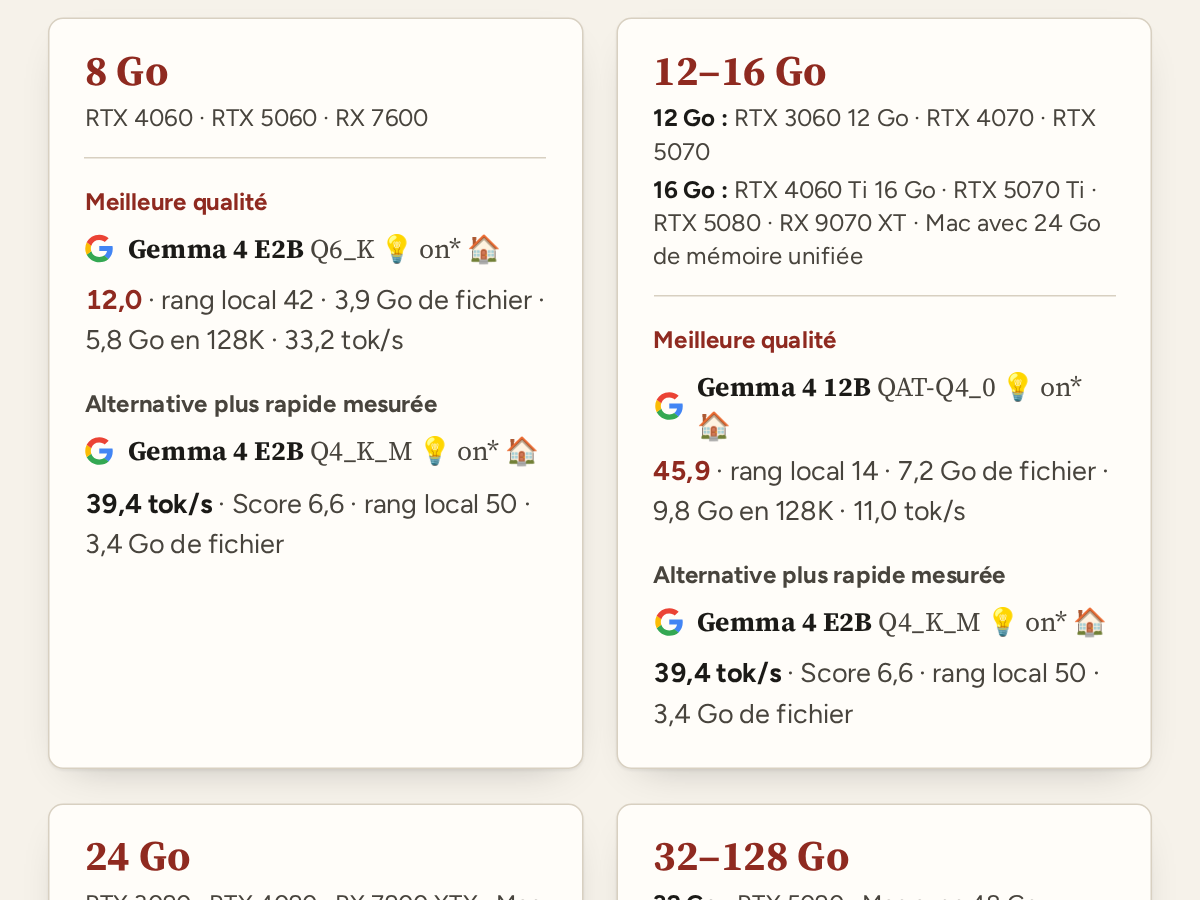
Le classement des IA locales indique la mémoire nécessaire pour le fichier et pour un contexte de 128K ou 256K, en GGUF ou en MLX, avec un cache F16 ou Q8. Des boutons au-dessus de chaque classement passent des derniers modèles à la génération précédente ou aux plus anciens.
75 000
Atteint 70 jours après le premier duel, 12 jours après le palier de 50 000.
Claude Opus 5.5. Aujourd’hui 3e sur 120, avec un score de 96,7. Soit 2,3 points de moins que son prédécesseur, Claude Opus 5 (1er, 99,0).
GPT-6 Luna. Aujourd’hui 19e sur 120, avec un score de 85,7. Soit 10,4 points de plus que son prédécesseur, GPT-5.6 Luna (28e, 75,3).
GPT-6 Sol. Aujourd’hui 9e sur 120, avec un score de 95,2. Soit 9,8 points de plus que son prédécesseur, GPT-5.6 Sol (20e, 85,4).
Les derniers modèles d’Anthropic et d’OpenAI prennent le relais comme juges, aux côtés de Muse Spark 1.3. Chaque verdict compare toujours deux textes anonymes écrits pour la même consigne.

Agnes 3.0 Flash. Aujourd’hui 73e sur 120, avec un score de 41,0.

Grok 4.7. Aujourd’hui 15e sur 120, avec un score de 89,1. Soit 55,2 points de plus que son prédécesseur, Grok 4.6 (81e, 33,9). Duels directs remportés contre lui : 10 sur 11 (91 %).

MiMo V2.6 Flash. Aujourd’hui 78e sur 120, avec un score de 38,2.
MiMo V2.6 Pro. Aujourd’hui 40e sur 120, avec un score de 69,2. Soit 11,4 points de plus que son prédécesseur, MiMo V2.5 Pro (54e, 57,8). Duels directs remportés contre lui : 25 sur 40 (63 %).
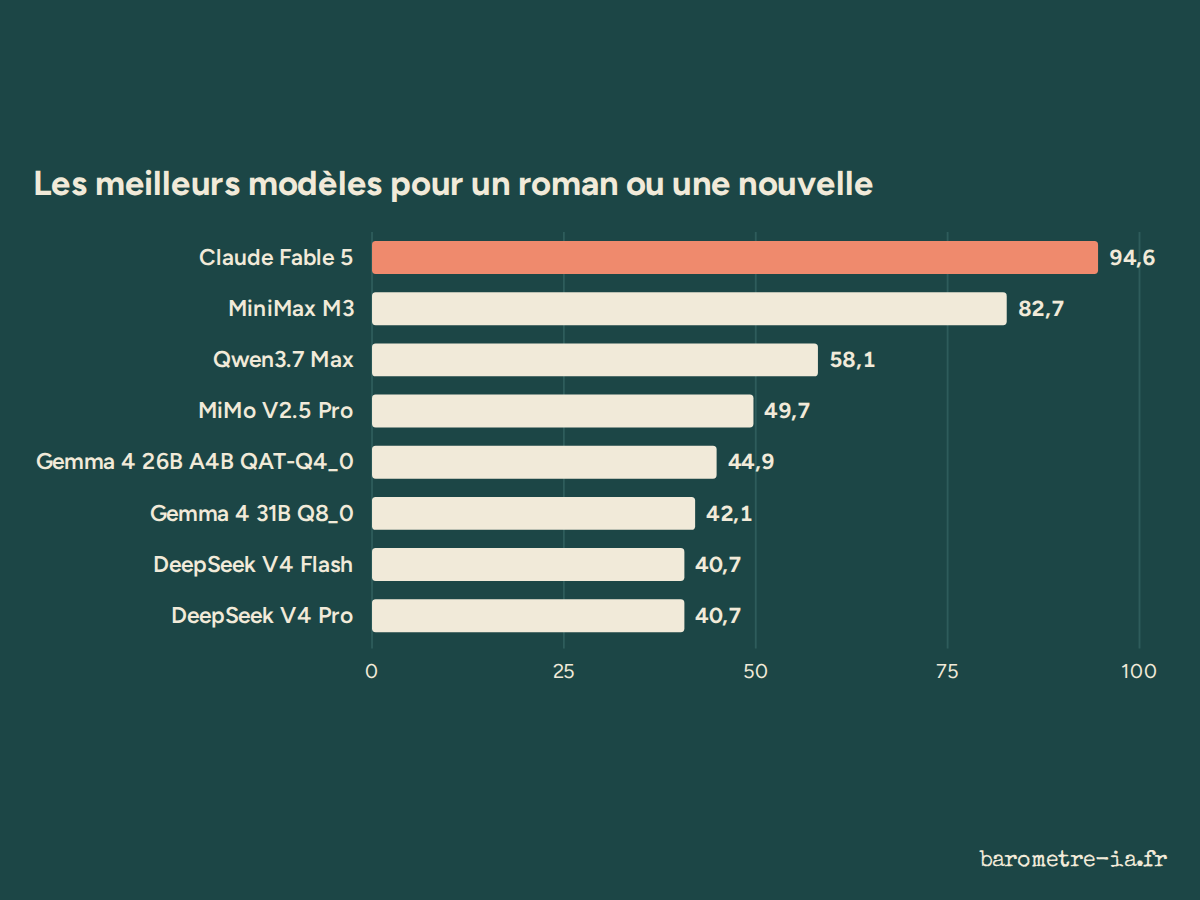 Quelle IA pour un roman, un e-mail, une lettre de motivation ou une dissertation ? Le meilleur modèle change avec le texte
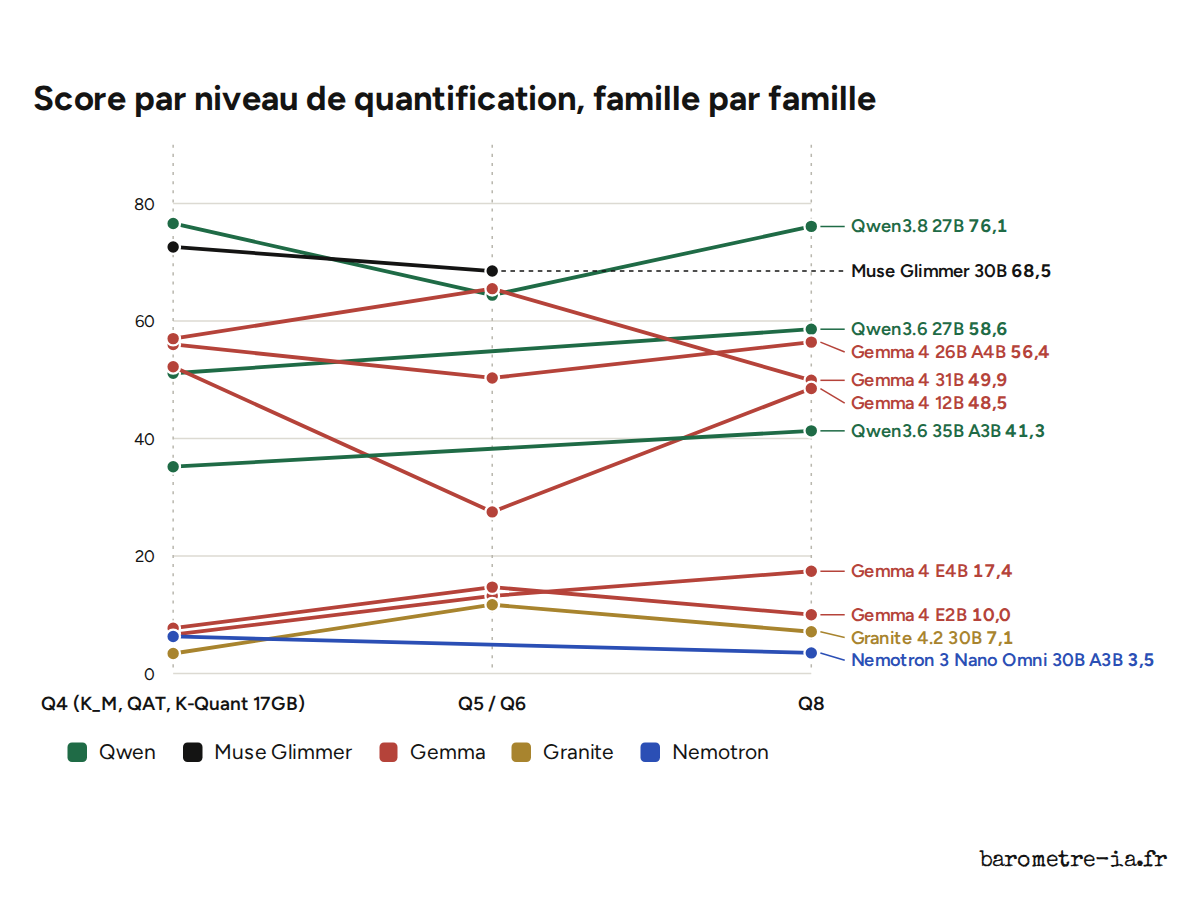 Q4, Q6 ou Q8 : la quantification ne coûte rien sur certains modèles et douze points sur d’autres
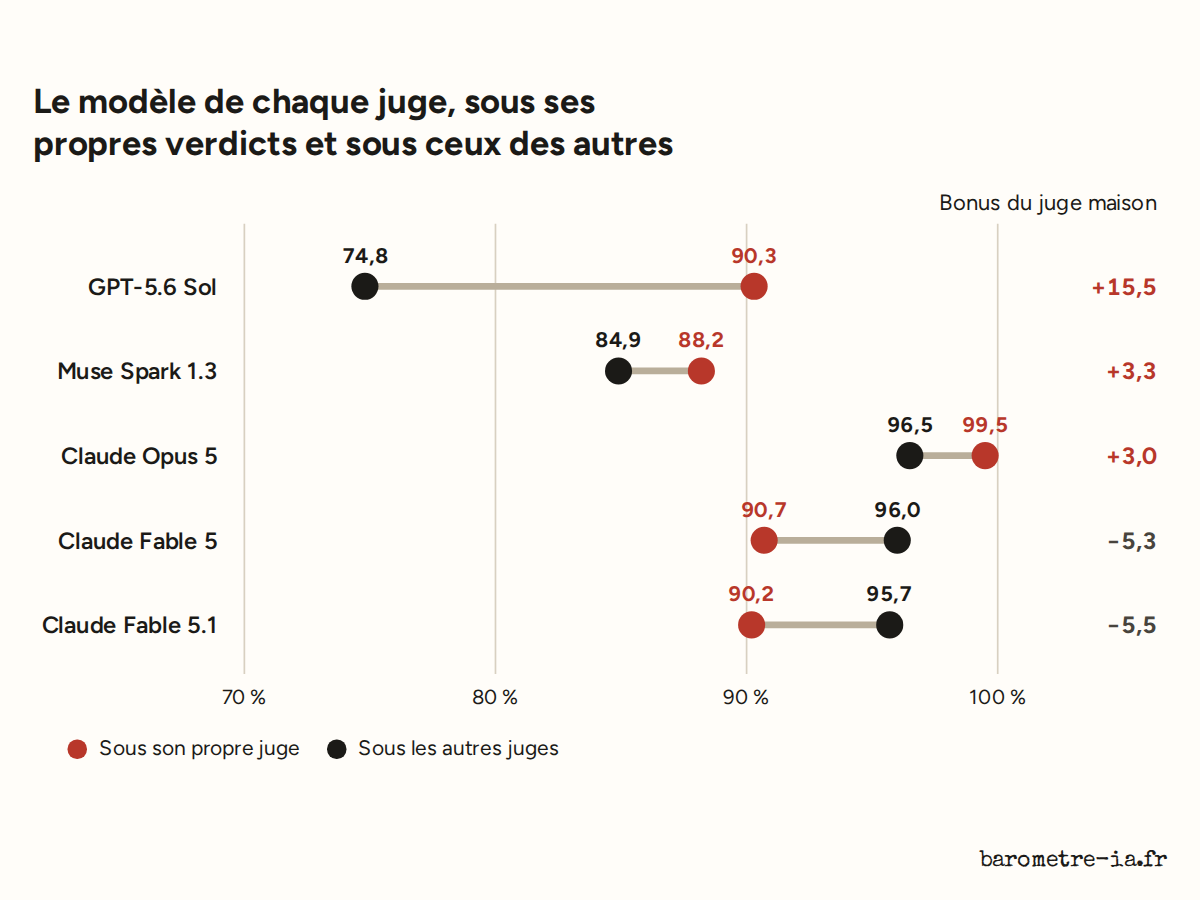 Les juges IA se favorisent-ils ? Deux sur cinq, jusqu’à 16 points d’écart
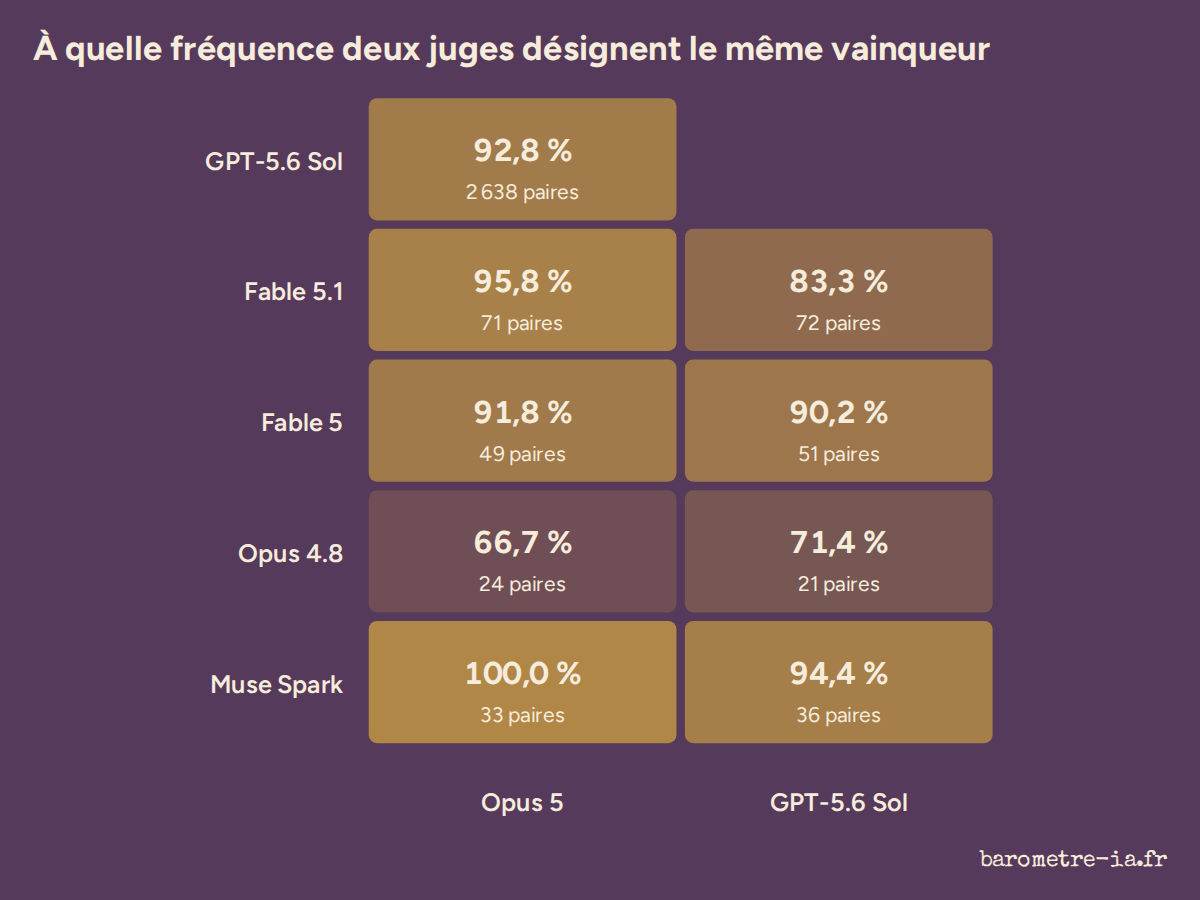 Les deux grands juges IA désignent le même vainqueur neuf fois sur dix. Les désaccords sont ailleurs
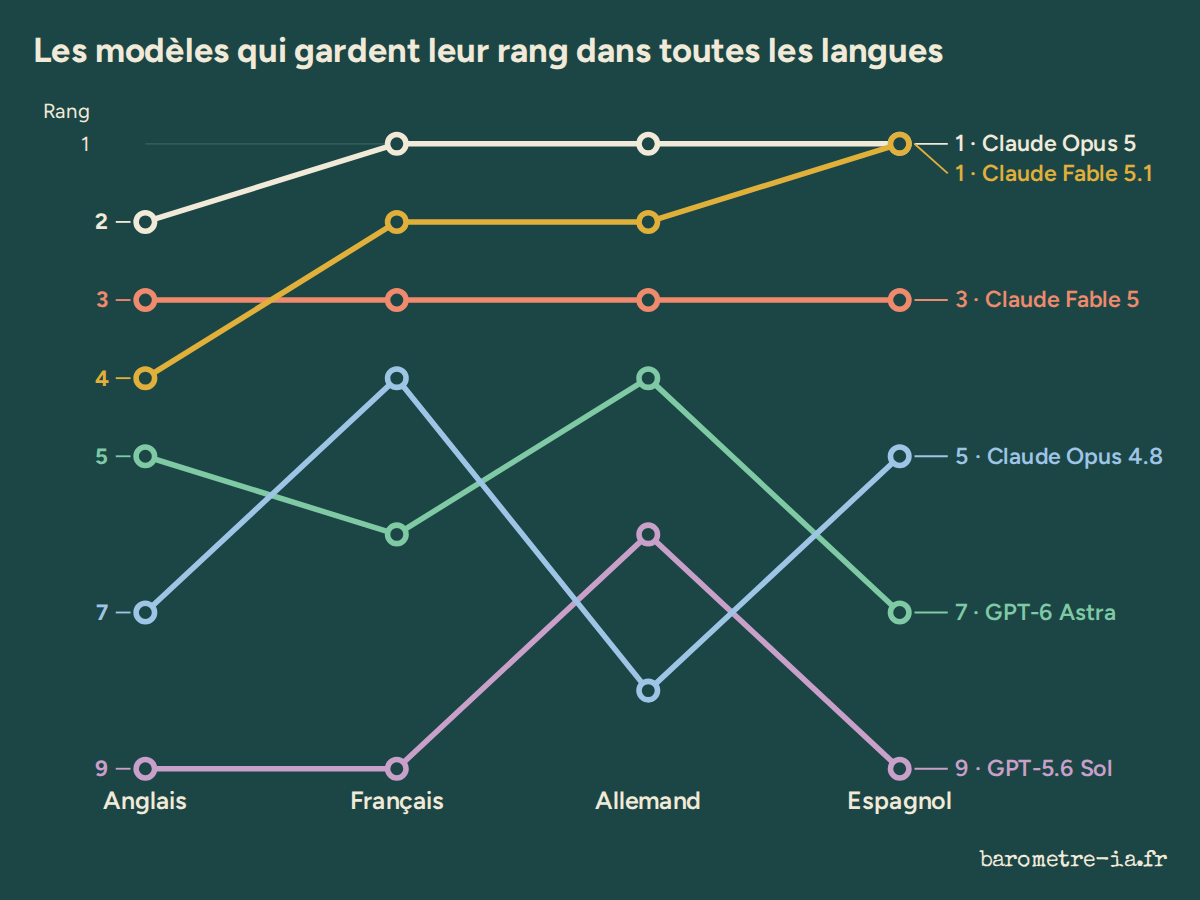 Même modèle, quatre langues : les six premiers ne bougent pas, le milieu de tableau se déplace de quarante places
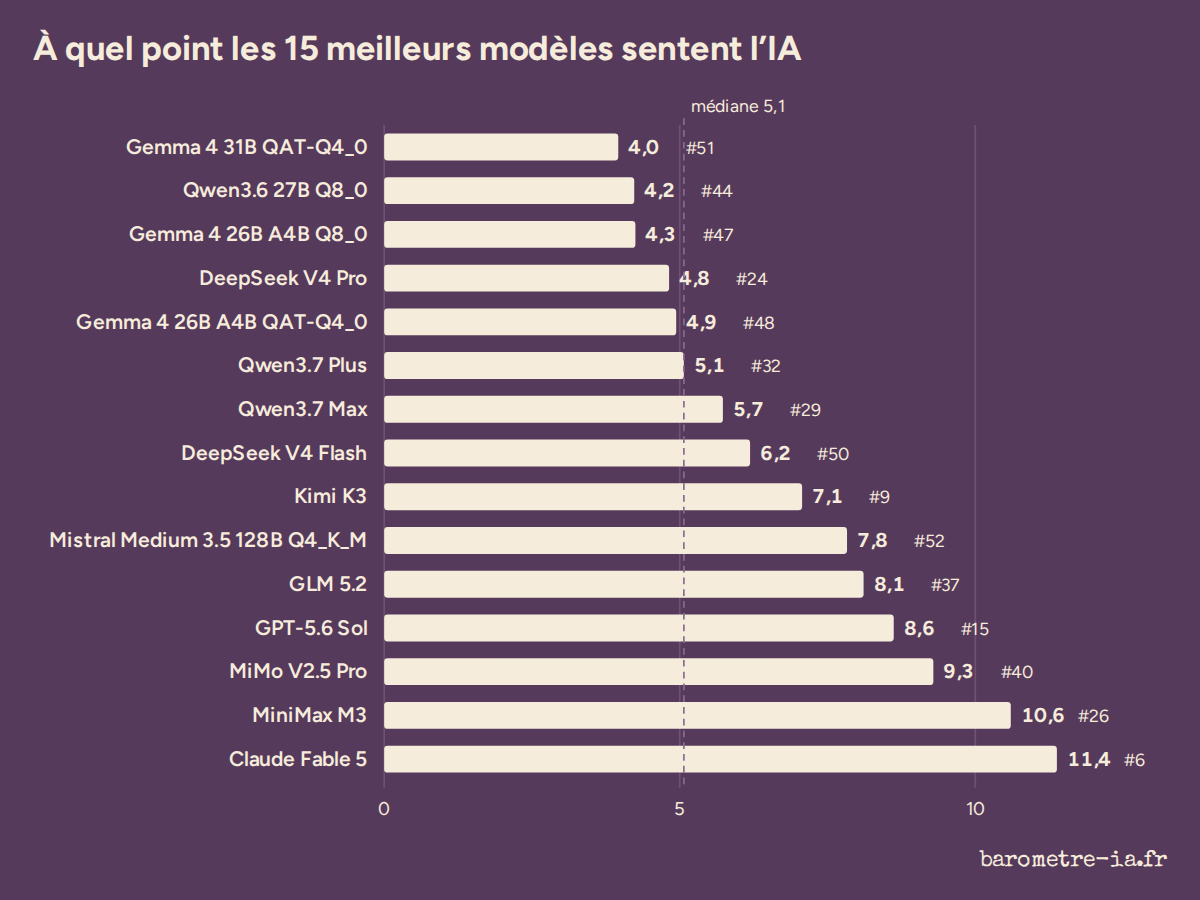 Quelle IA sent le moins l’IA ? « Véritable », les tirets cadratins et les meilleurs modèles
Claude ou ChatGPT, Claude ou Gemini, Gemma ou Qwen : les duels les plus recherchés ont désormais leur page, avec le verdict des duels à l’aveugle. Chaque modèle classé reçoit aussi un indice des tics de la prose machine : formules toutes faites, tirets cadratins, énumérations par trois.
Ling 3.0 Flash. Aujourd’hui 61e sur 120, avec un score de 49,0. Meilleure de ses 2 variantes classées : Ling 3.0 Flash d’InclusionAI (Q4_K_M, raisonnement high).
50 000
Atteint 58 jours après le premier duel, 21 jours après le palier de 25 000.

DeepSeek V4.1 Flash. Aujourd’hui 21e sur 120, avec un score de 84,1. Soit 37,6 points de plus que son prédécesseur, DeepSeek V4 Flash (67e, 46,5).
GPT-6 Astra. Aujourd’hui 8e sur 120, avec un score de 95,4.
Claude Fable 5.1. Aujourd’hui 4e sur 120, avec un score de 96,5. À égalité avec son prédécesseur, Claude Fable 5 (5e, 96,4).
Gemini 3.8 Flash. Aujourd’hui 24e sur 120, avec un score de 82,7. Soit 12,6 points de plus que son prédécesseur, Gemini 3.6 Flash (34e, 70,1).
Muse Spark 1.3. Aujourd’hui 15e sur 120, avec un score de 89,1. Soit 5,7 points de plus que son prédécesseur, Muse Spark 1.2 (22e, 83,4).
Inkling. Aujourd’hui 53e sur 120, avec un score de 60,0.

Granite 4.2 8B. Aujourd’hui 119e sur 120, avec un score de 1,4. Meilleure de ses 2 variantes classées : Granite 4.2 8B d’IBM (Q8_0, raisonnement full).

GLM 5.3 Flash. Aujourd’hui 47e sur 120, avec un score de 63,9.
Granite 4.2 30B. Aujourd’hui 104e sur 120, avec un score de 9,0. Meilleure de ses 3 variantes classées : Granite 4.2 30B d’IBM (Q6_K, raisonnement full).

Hy4 Preview. Aujourd’hui 42e sur 120, avec un score de 67,1. Soit 17,9 points de plus que son prédécesseur, Hy3 (60e, 49,2). Duels directs remportés contre lui : 15 sur 23 (65 %).
Qwen3.8 Flash. Aujourd’hui 44e sur 120, avec un score de 67,0.
25 000
Atteint 37 jours après le premier duel.
75
Avec Seed 2.1 Turbo, 34 jours après le premier duel.
Aion 3.0. Aujourd’hui 58e sur 120, avec un score de 52,3.
GLM 5.3. Aujourd’hui 18e sur 120, avec un score de 87,1. Soit 25,9 points de plus que son prédécesseur, GLM 5.2 (50e, 61,2). Duels directs remportés contre lui : 21 sur 23 (91 %).
Grok 4.6. Aujourd’hui 81e sur 120, avec un score de 33,9.
Hy3. Aujourd’hui 60e sur 120, avec un score de 49,2.
Mistral Medium 3.5. Aujourd’hui 86e sur 120, avec un score de 31,0.
Muse Spark 1.2. Aujourd’hui 22e sur 120, avec un score de 83,4.
Qwen3.8 Max. Aujourd’hui 31e sur 120, avec un score de 72,4. Soit 3,1 points de plus que son prédécesseur, Qwen3.7 Max (38e, 69,3).

Seed 2.1 Turbo. Aujourd’hui 51e sur 120, avec un score de 60,7.
Qwen3.8 27B. Aujourd’hui 35e sur 120, avec un score de 70,0. Meilleure de ses 6 variantes classées : Qwen3.8 27B d’Alibaba (Q4_K_M, raisonnement xhigh). Soit 19,6 points de plus que son prédécesseur, Qwen3.6 27B (59e, 50,4).
50
Avec Gemma 4 12B, 28 jours après le premier duel.
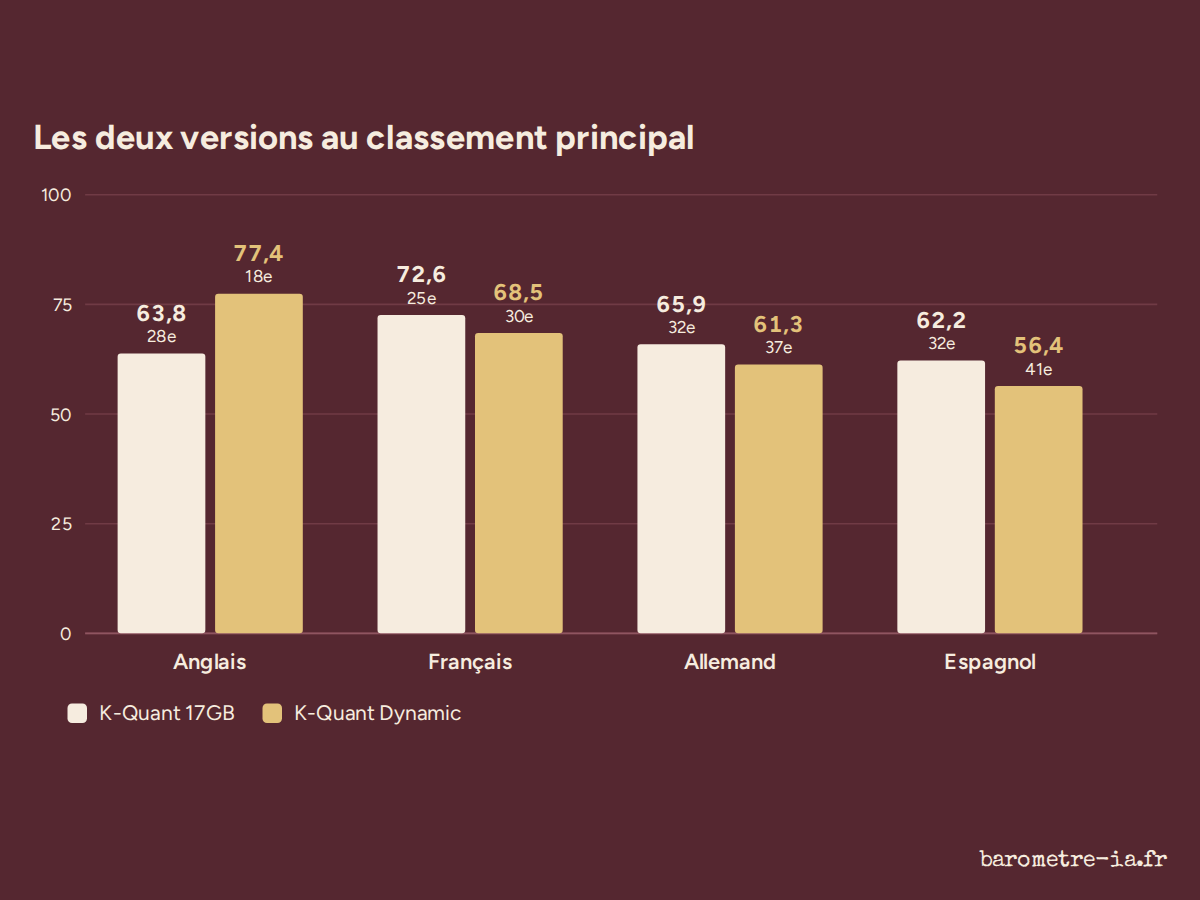
Muse Glimmer 30B. Aujourd’hui 41e sur 120, avec un score de 68,9. Meilleure de ses 2 variantes classées : Muse Glimmer 30B de Meta (K-Quant 17GB, raisonnement high).
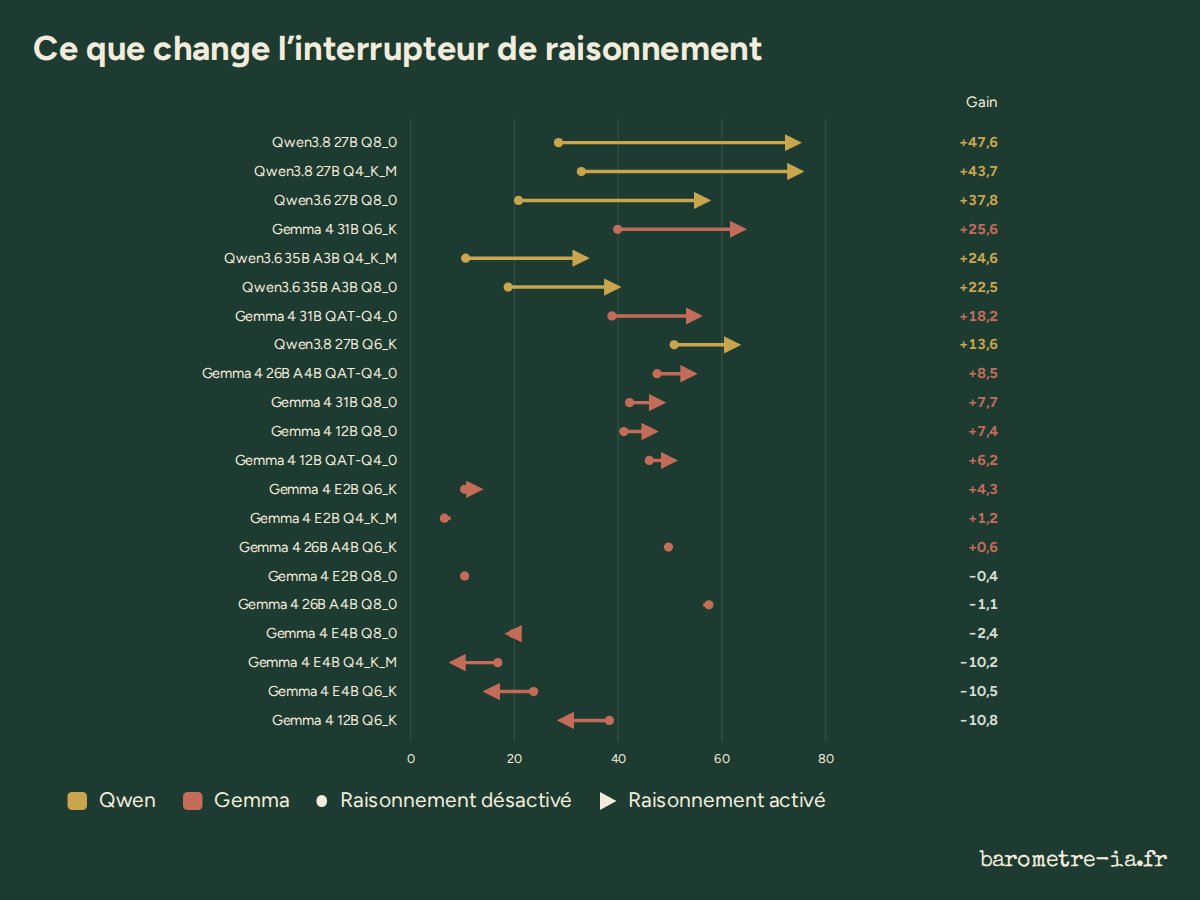
Gemma 4 E2B. Aujourd’hui 102e sur 120, avec un score de 11,6. Meilleure de ses 6 variantes classées : Gemma 4 E2B de Google (Q6_K, raisonnement activé).
Gemma 4 E4B. Aujourd’hui 94e sur 120, avec un score de 19,0. Meilleure de ses 6 variantes classées : Gemma 4 E4B de Google (Q6_K, sans raisonnement).
Nemotron 3 Super 120B A12B. Aujourd’hui 89e sur 120, avec un score de 29,9.

Laguna S 2.1 UD. Aujourd’hui 116e sur 120, avec un score de 4,3.
Nemotron 3 Nano Omni 30B A3B. Aujourd’hui 112e sur 120, avec un score de 5,4. Meilleure de ses 2 variantes classées : Nemotron 3 Nano Omni 30B A3B de NVIDIA (Q4_K_M, raisonnement activé).
Claude Sonnet 5. Aujourd’hui 14e sur 120, avec un score de 89,5.
Gemini 3.6 Flash. Aujourd’hui 34e sur 120, avec un score de 70,1.
Claude Opus 5. Aujourd’hui 1er sur 120, avec un score de 99,0. Soit 3,4 points de plus que son prédécesseur, Claude Opus 4.8 (6e, 95,6).
GPT-5.6 Luna. Aujourd’hui 28e sur 120, avec un score de 75,3.
Kimi K3. Aujourd’hui 12e sur 120, avec un score de 91,9.
25
Avec Claude Fable 5, 7 jours après le premier duel.
Claude Fable 5. Aujourd’hui 5e sur 120, avec un score de 96,4.
GPT-5.6 Sol. Aujourd’hui 20e sur 120, avec un score de 85,4.
Claude Opus 4.8. Aujourd’hui 6e sur 120, avec un score de 95,6.
GPT-5.6 Terra. Aujourd’hui 28e sur 120, avec un score de 75,3.
MiniMax M3. Aujourd’hui 38e sur 120, avec un score de 69,3.
DeepSeek V4 Pro. Aujourd’hui 35e sur 120, avec un score de 70,0. Meilleure de ses 2 variantes classées : DeepSeek V4 Pro de DeepSeek (raisonnement activé).
Gemma 4 12B. Aujourd’hui 69e sur 120, avec un score de 44,6. Meilleure de ses 6 variantes classées : Gemma 4 12B de Google (QAT-Q4_0, raisonnement activé).
Gemma 4 26B A4B. Aujourd’hui 62e sur 120, avec un score de 48,7. Meilleure de ses 6 variantes classées : Gemma 4 26B A4B de Google (Q8_0, sans raisonnement).
Gemma 4 31B. Aujourd’hui 55e sur 120, avec un score de 56,4. Meilleure de ses 6 variantes classées : Gemma 4 31B de Google (Q6_K, raisonnement activé).
GLM 5.2. Aujourd’hui 50e sur 120, avec un score de 61,2.
MiMo V2.5 Pro. Aujourd’hui 54e sur 120, avec un score de 57,8. Meilleure de ses 2 variantes classées : MiMo V2.5 Pro de Xiaomi (raisonnement activé).
Mistral Medium 3.5 128B. Aujourd’hui 68e sur 120, avec un score de 46,3.
Qwen3.6 27B. Aujourd’hui 59e sur 120, avec un score de 50,4. Meilleure de ses 3 variantes classées : Qwen3.6 27B d’Alibaba (Q8_0, raisonnement activé).
Qwen3.6 35B A3B. Aujourd’hui 82e sur 120, avec un score de 33,2. Meilleure de ses 4 variantes classées : Qwen3.6 35B A3B d’Alibaba (Q8_0, raisonnement activé).
Qwen3.7 Max. Aujourd’hui 38e sur 120, avec un score de 69,3. Meilleure de ses 2 variantes classées : Qwen3.7 Max d’Alibaba (raisonnement activé).
Tous les modèles classés sur l’écriture en français, avec des filtres par type de texte, éditeur, taille, raisonnement et quantification, et les matrices de duels.
Le classement vivant des modèles à poids ouverts pour écrire en français, la mémoire que demande chaque fichier et ce qui tient dans 16, 24, 32 ou 128 Go.
Des articles fondés sur les données : les juges, la quantification, le raisonnement et les quatre langues.