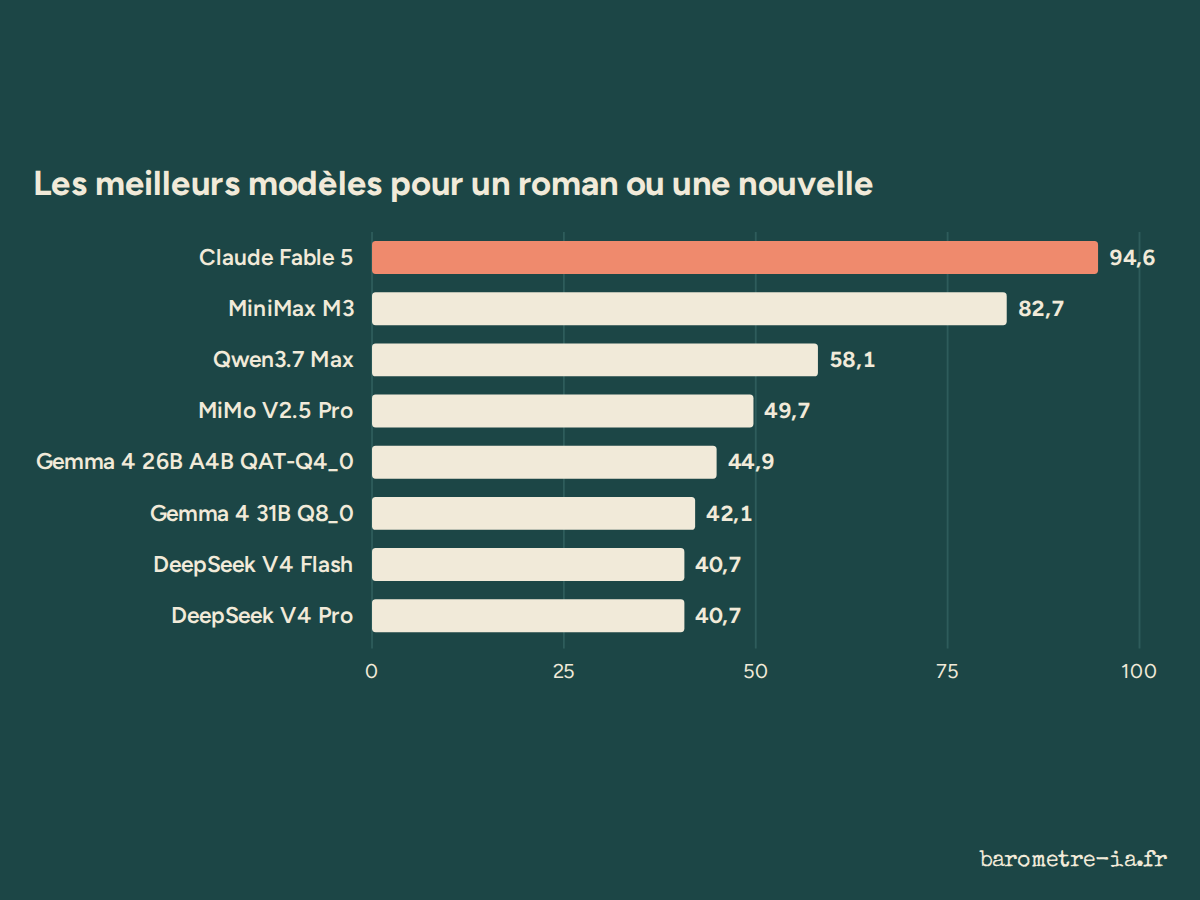
Les modèles sont classés selon la qualité des textes produits en français. Utilisez les filtres pour affiner la liste. Pour les catégories d’écriture sélectionnées, les rangs sont calculés avant les filtres d’éditeur, de taille, d’accès, de raisonnement et de quantification ; les modèles masqués peuvent donc laisser des écarts.
Dernière actualisation :
Classement des modèles d’écriture fondé sur les résultats par paires
Rang
Modèle
Score juge IA
Score humain
1
Claude Opus 5 💡 adaptive high
99,0
—
2
GPT-6.1 Sol 💡 high
97,2
—
3
Claude Opus 5.5 💡 adaptive high
96,7
—
4
Claude Fable 5.1 💡 adaptive high
96,5
—
5
Claude Fable 5 💡 adaptive high
96,4
—
7
Claude Fable 5.2 💡 adaptive high
95,5
—
8
GPT-6 Astra 💡 high
95,4
—
9
Claude Sonnet 5.5 💡 adaptive high
95,2
—
9
GPT-6 Sol 💡 high
95,2
—
11
GPT-6.1 Terra 💡 high
92,4
—
12
Kimi K3 💡 enabled
91,9
—
13
Gemini 4 Hydrogen 💡 high
89,8
—
14
Claude Sonnet 5 💡 adaptive high
89,5
—
15
Grok 4.7 💡 high
89,1
—
15
Muse Spark 1.3 💡 high
89,1
—
17
Kimi K3.1 Pro 💡 high
87,3
—
18
GLM 5.3 💡 max
87,1
—
19
GPT-6 Luna 💡 high
85,7
—
20
GPT-5.6 Sol 💡 high
85,4
—
21
DeepSeek V4.1 Flash 💡 high
84,1
—
22
Muse Spark 1.2 💡 high
83,4
—
23
Qwen4 Max 💡 high
83,0
—
24
Gemini 3.8 Flash 💡 high
82,7
—
25
Gemini 4 Argon 💡 high
77,5
—
26
Aion 3.5 💡 high
77,4
—
27
Muse Ember 💡 high
77,0
—
28
GPT-5.6 Luna 💡 high
75,3
—
28
GPT-5.6 Terra 💡 high
75,3
—
30
Ling 3.1 Flash 💡 high
73,7
—
31
Qwen3.8 Max 💡 xhigh
72,4
—
32
Nemotron 3.5 Super VL 💡 high
71,4
—
33
Beam 1.0 💡 high
70,2
—
35
DeepSeek V4 Pro 💡 enabled
70,0
—
37
Claude Haiku 5.5 💡 adaptive high
69,4
—
38
Qwen3.7 Max 💡 enabled
69,3
—
38
MiniMax M3 💡 enabled
69,3
—
40
MiMo V2.6 Pro fp8 💡 high
69,2
—
42
Hy4 Preview 💡 high
67,1
—
42
Qwen3.8 27B Q8_0 💡 xhigh** 🏠
67,1
—
44
Qwen3.8 Flash 💡 high
67,0
—
45
Qwen3.7 Plus 💡 enabled
66,0
—
46
Nemotron 3 Ultra 💡 high
65,4
—
47
GLM 5.3 Flash 💡 high
63,9
—
48
Ling 3.2 Flash 💡 high
62,3
—
49
Mercury 3 💡 high
61,5
—
50
GLM 5.2 💡 enabled
61,2
—
51
Seed 2.1 Turbo ↯
60,7
—
53
Inkling 💡 high
60,0
—
54
MiMo V2.5 Pro 💡 enabled
57,8
—
57
Mistral Large 4 💡 high
53,3
—
58
Aion 3.0 💡 mandatory
52,3
—
59
Qwen3.6 27B Q8_0 💡 on* 🏠
50,4
—
60
Hy3 💡 high
49,2
—
62
Gemma 4 26B A4B Q8_0 ↯ 🏠
48,7
—
63
Step 5 Preview fp8 💡 high
47,8
—
65
Gemma 4 26B A4B Q8_0 💡 on* 🏠
47,0
—
67
DeepSeek V4 Flash 💡 enabled
46,5
—
73
Agnes 3.0 Flash 💡 high
41,0
—
74
Gemma 4 12B Q8_0 💡 on* 🏠
40,7
—
75
Gemma 4 31B Q8_0 💡 on* 🏠
40,5
—
76
MiMo V2.5 💡 enabled
39,8
—
78
MiMo V2.6 Flash 💡 high
38,2
—
81
Grok 4.6 💡 high
33,9
—
82
Qwen3.6 35B A3B Q8_0 💡 on* 🏠
33,2
—
83
Gemma 4 31B Q8_0 ↯ 🏠
32,9
—
84
Gemma 4 12B Q8_0 ↯ 🏠
32,3
—
86
Mistral Medium 3.5 💡 high
31,0
—
93
Qwen3.8 27B Q8_0 ↯ 🏠
21,1
—
95
Nemotron 3.5 Lightning 💡 high
17,9
—
97
Gemma 4 E4B Q8_0 ↯ 🏠
16,2
—
98
Qwen3.6 27B Q8_0 ↯ 🏠
16,1
—
99
Gemma 4 E4B Q8_0 💡 on* 🏠
13,9
—
100
Qwen3.6 35B A3B Q8_0 ↯ 🏠
13,8
—
105
Gemma 4 E2B Q8_0 ↯ 🏠
8,0
—
106
Gemma 4 E2B Q8_0 💡 on* 🏠
7,9
—
108
Flint V1.0 💡 high
7,6
—
110
Granite 4.2 30B Q8_0 💡 full 🏠
7,2
—
114
MiniMax M3.1 Flash 💡 high
5,1
—
118
Nemotron 3 Nano Omni 30B A3B Q8_0 💡 on* 🏠
3,1
—
119
Granite 4.2 8B Q8_0 💡 full 🏠
1,4
—
Aucun résultat publié pour cette sélection
Un modèle apparaît après sa première évaluation individuelle publiée ; son score de classement apparaît après son premier duel admissible.
120 modèles comparés · 125 324 verdicts IA publiés
Méthode : modèle de Bradley–Terry régularisé. Le score des juges IA détermine le rang ; le score humain est indépendant et reste secondaire tant que les votes de la communauté sont peu nombreux. Un score de 50 correspond à une chance estimée sur deux de battre le modèle moyen dans cette langue et cette catégorie.
Résultats des duels directs
Chaque cellule indique la part des points possibles obtenue par le modèle de la ligne face au modèle de la colonne : une victoire vaut 100 %, une égalité 50 %, une défaite 0 %. Cette matrice n’utilise que les protocoles d’évaluation compatibles avec le classement principal.
Matrice orientée des points obtenus en duel direct. Au-dessus de 50 %, l’avantage va au modèle de la ligne ; en dessous, au modèle de la colonne.
0 %100 %
💡 signale un modèle avec raisonnement, ↯ un modèle sans raisonnement. 🏠 signale un modèle exécuté localement sur la machine de l’auteur de ce site.« on* » indique que le raisonnement est activé ou désactivé (modèles locaux sans niveaux intermédiaires) : le réglage fin demandé n’est pas pris en charge par le fichier local et retombe sur le mode activé par défaut. Sur les modèles locaux à raisonnement réglable (Qwen3.8, Muse Glimmer, Granite 4.2, Nemotron 3 Super, K2 Horizon, Ling 3.0 Flash), le niveau affiché (xhigh**, high, full) est le niveau par défaut du modèle : le réglage fin demandé n’est pas pris en charge par le fichier local, qui retombe sur son comportement par défaut.
Afficher sous forme de tableau
Points obtenus en duel direct par paire de modèles
Modèle
Couverture des duels publiés
Chaque cellule indique combien de duels jugés par IA et publiés, tous protocoles confondus, comparent les deux modèles pour cette langue et cette catégorie. Les modèles des deux axes sont des candidats ; la matrice n’indique pas quel juge a produit chaque verdict.
Matrice symétrique du nombre de duels publiés. La diagonale vaut zéro : un modèle n’est pas comparé à lui-même.
0
💡 signale un modèle avec raisonnement, ↯ un modèle sans raisonnement. 🏠 signale un modèle exécuté localement sur la machine de l’auteur de ce site.« on* » indique que le raisonnement est activé ou désactivé (modèles locaux sans niveaux intermédiaires) : le réglage fin demandé n’est pas pris en charge par le fichier local et retombe sur le mode activé par défaut. Sur les modèles locaux à raisonnement réglable (Qwen3.8, Muse Glimmer, Granite 4.2, Nemotron 3 Super, K2 Horizon, Ling 3.0 Flash), le niveau affiché (xhigh**, high, full) est le niveau par défaut du modèle : le réglage fin demandé n’est pas pris en charge par le fichier local, qui retombe sur son comportement par défaut.
Afficher sous forme de tableau
Nombre de duels publiés par paire de modèles
Modèle
Lancez un duel
Quel modèle écrit le meilleur texte ? Jugez cette paire anonyme et contribuez au classement humain. Pendant le duel, le nom des modèles reste masqué. Il n’est révélé qu’après votre choix.
Le classement a un vainqueur ; vos textes n’en ont pas un seul. Au 20 septembre, sur les seuls duels d’un type de texte, Claude Fable 5 dominait la fiction et la dissertation, Claude Opus 5 les lettres personnelles, Claude Fable 5.1 les lettres de motivation. Un guide simple, tâche par tâche, avec le meilleur fichier à faire tourner chez soi pour chacune.
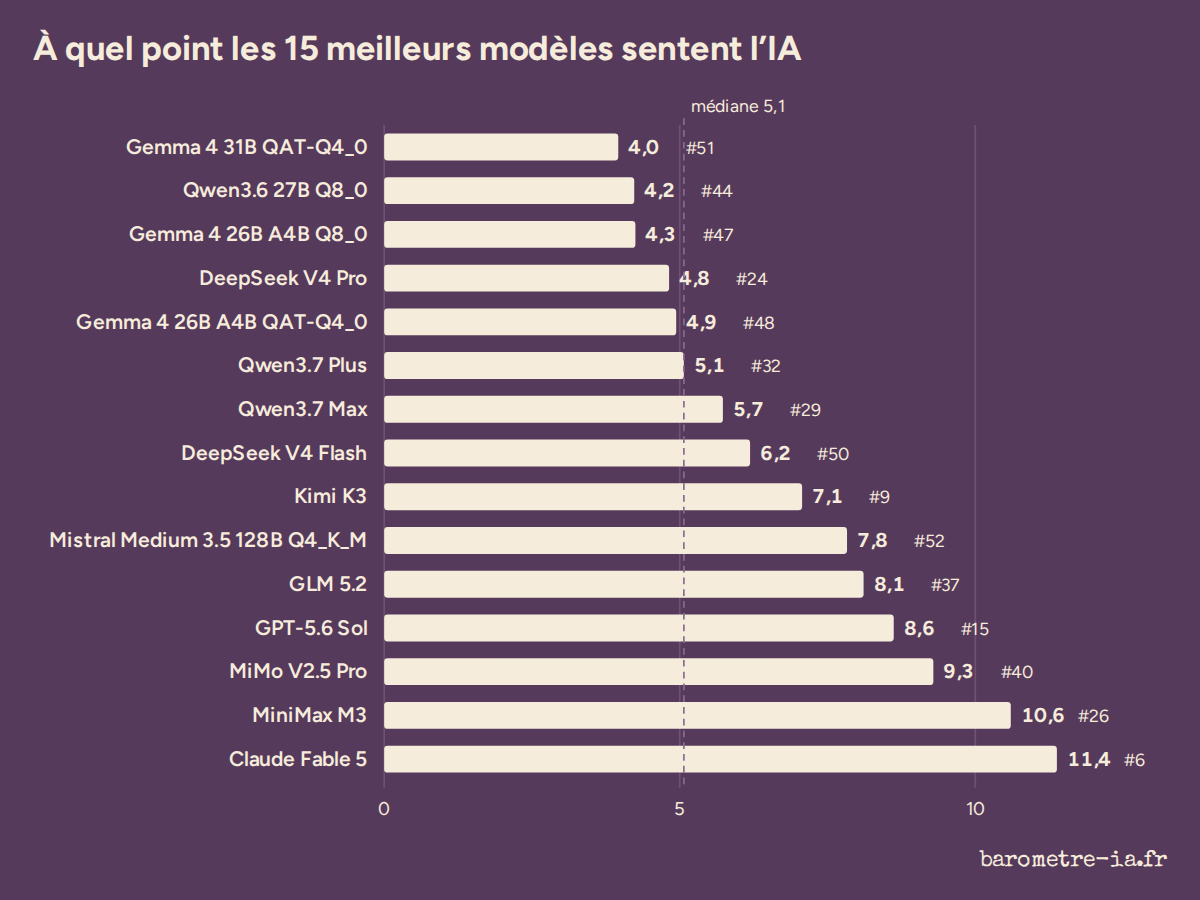
Nous avons compté, dans 3 574 textes classés en français, les marques que les lecteurs appellent « de l’IA » : tirets cadratins, formules toutes faites, « non pas X mais Y », listes de trois, calques de l’anglais. Claude Fable 5, alors troisième du classement, en a le plus ; les modèles les plus sobres sont des fichiers locaux en milieu de tableau. Et « véritable » apparaît 494 fois.
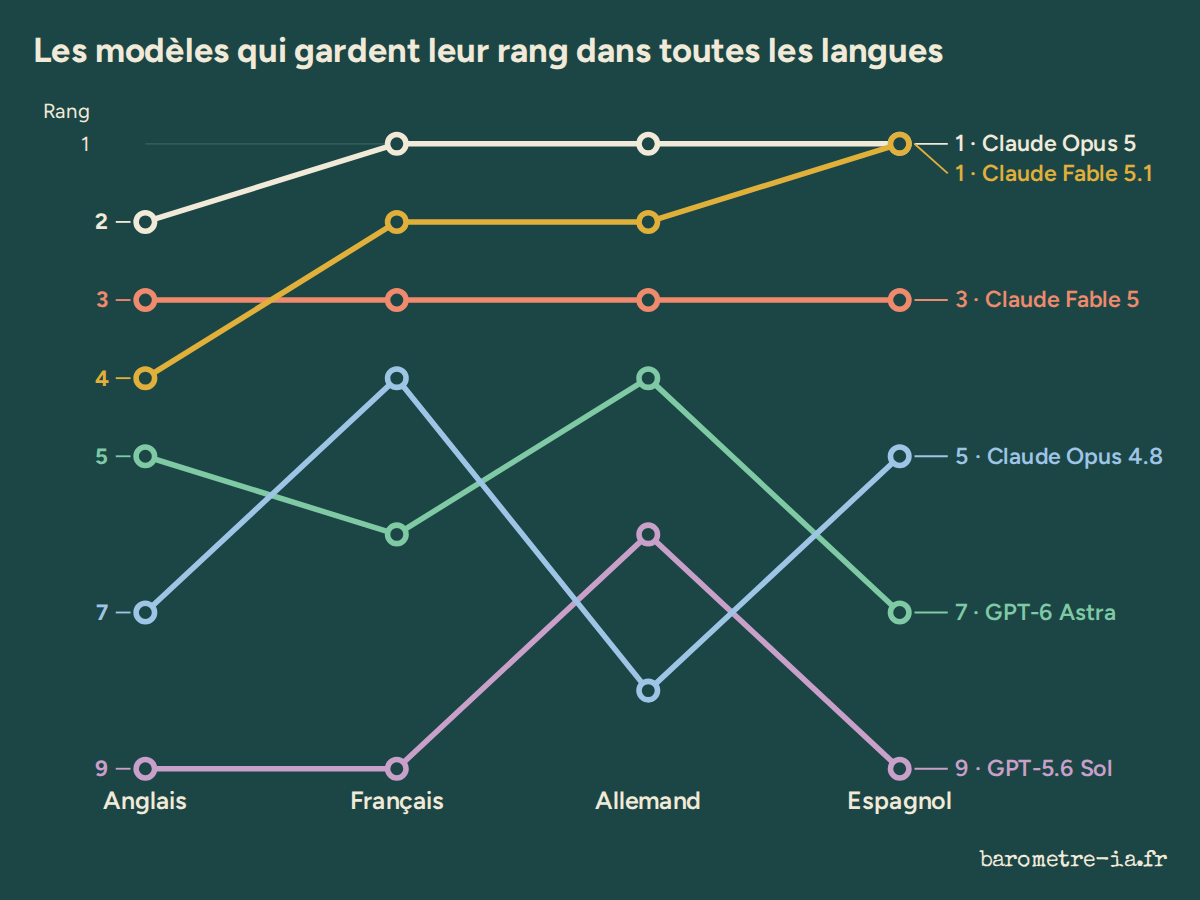
Quatre-vingt-onze modèles sont classés en anglais, en français, en allemand et en espagnol selon le même protocole. Au 19 septembre, Claude Fable 5 était troisième dans les quatre langues, Claude Opus 5 premier en français. Plus bas, Grok 4.6 était 25e en anglais et 60e en français, et Qwen3.8 27B le meilleur modèle local en français mais l’un des plus faibles en allemand.
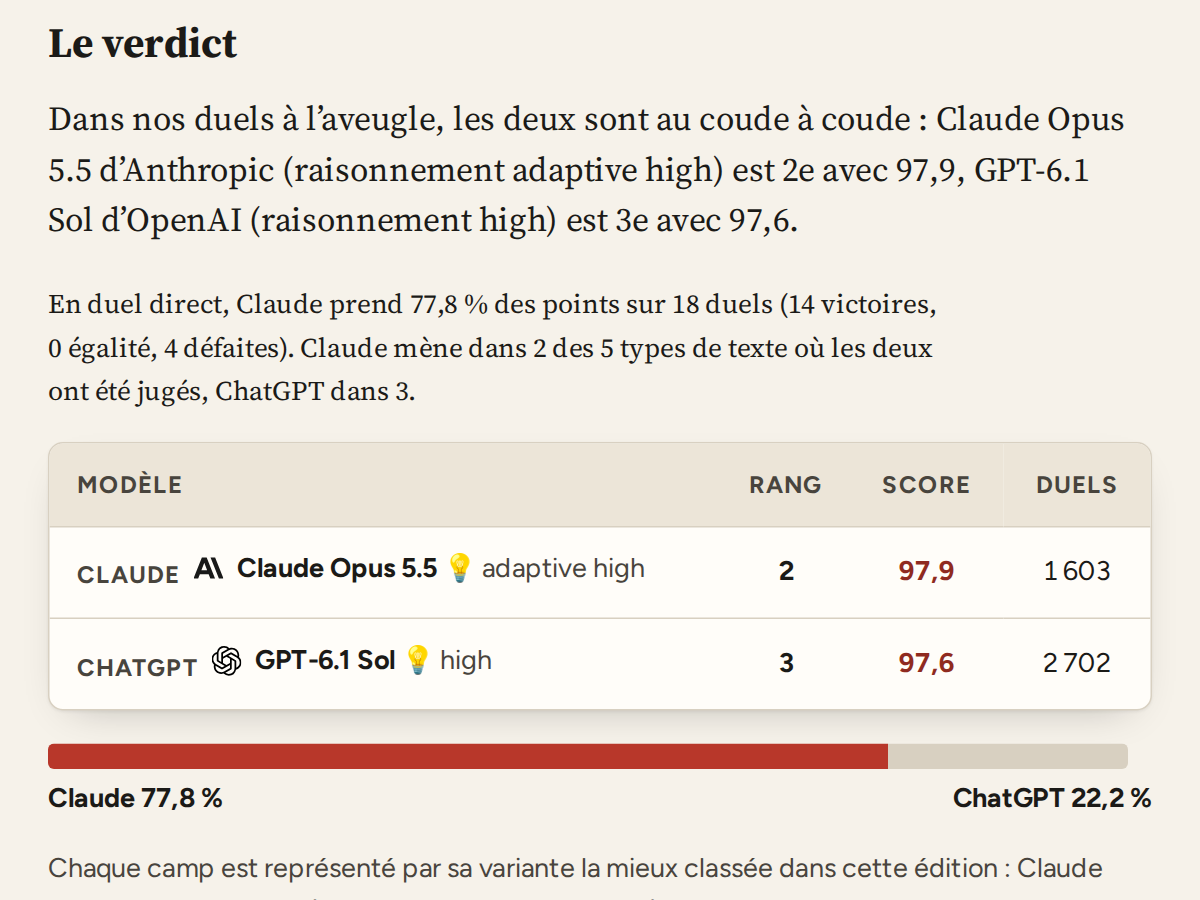
Les deux assistants les plus demandés, jugés sur les mêmes consignes en français dans des duels à l’aveugle : lequel écrit le mieux, de combien, et pour quels types de texte. Mis à jour à chaque export du classement.
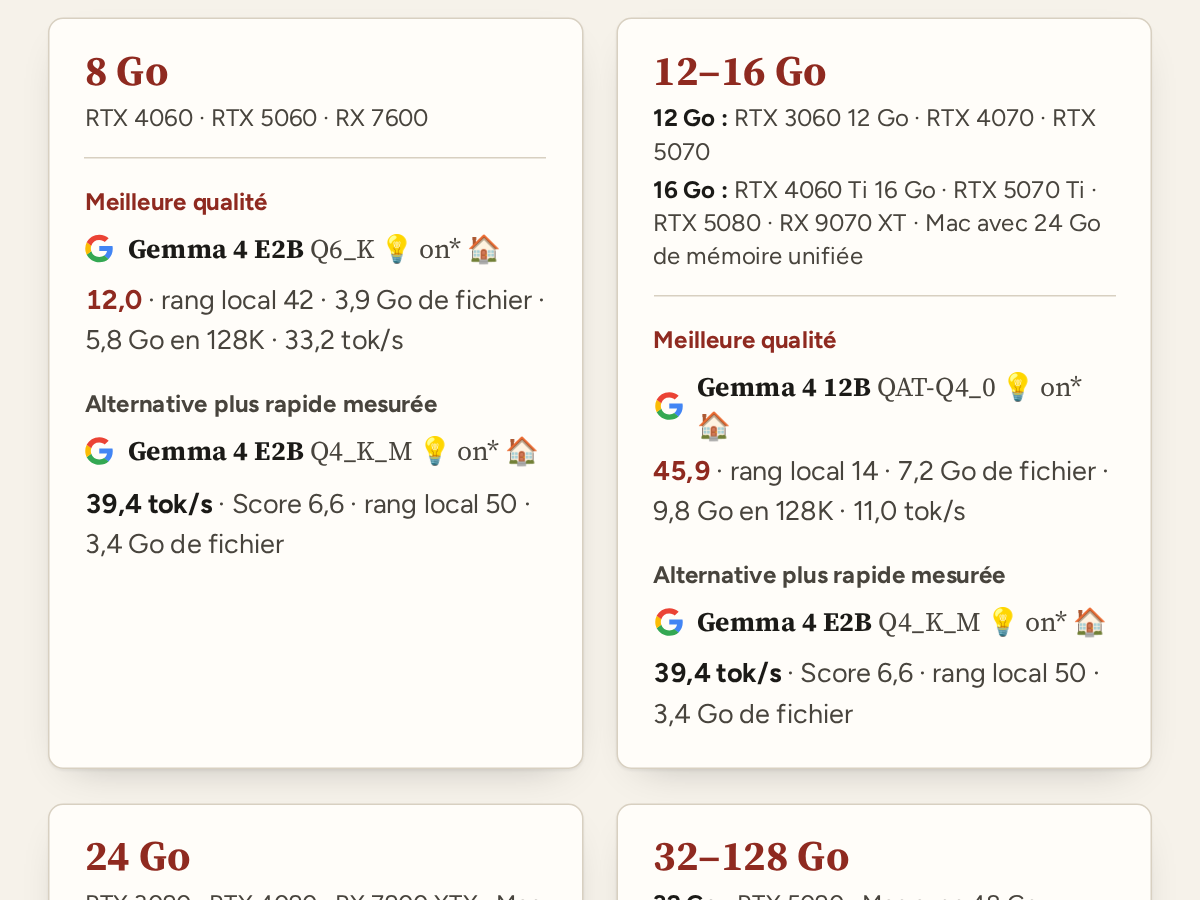
Le classement vivant des modèles à poids ouverts pour écrire en français, la mémoire que demande chaque fichier et ce qui tient dans 16, 24, 32 ou 128 Go.