Filigrane des textes IA : Claude, Gemini et OpenAI marquent ce qu’ils écrivent
Depuis cet été, les textes de Claude et de Gemini portent une marque invisible ; depuis le 5 octobre, ceux de ChatGPT et de Codex aussi, en Europe, et l’API d’OpenAI peut être mise en demande pour poser la marque. Ceux de Grok, Mistral, Meta AI et des modèles installés sur son ordinateur n’en portent aucune, et les services chinois se contentent d’une mention visible. Mais personne, hors des entreprises concernées, ne peut aujourd’hui vérifier un texte.
Un professeur peut-il savoir qu’une dissertation sort d’une IA ? Un recruteur, qu’une lettre de motivation a été écrite par ChatGPT ? Depuis cet été, la réponse dépend du modèle utilisé. Trois entreprises glissent désormais dans les textes qu’elles écrivent une marque invisible, un filigrane — Anthropic partout, Google partout, OpenAI en Europe — que leurs propres outils savent retrouver. Les autres n’en mettent pas encore.
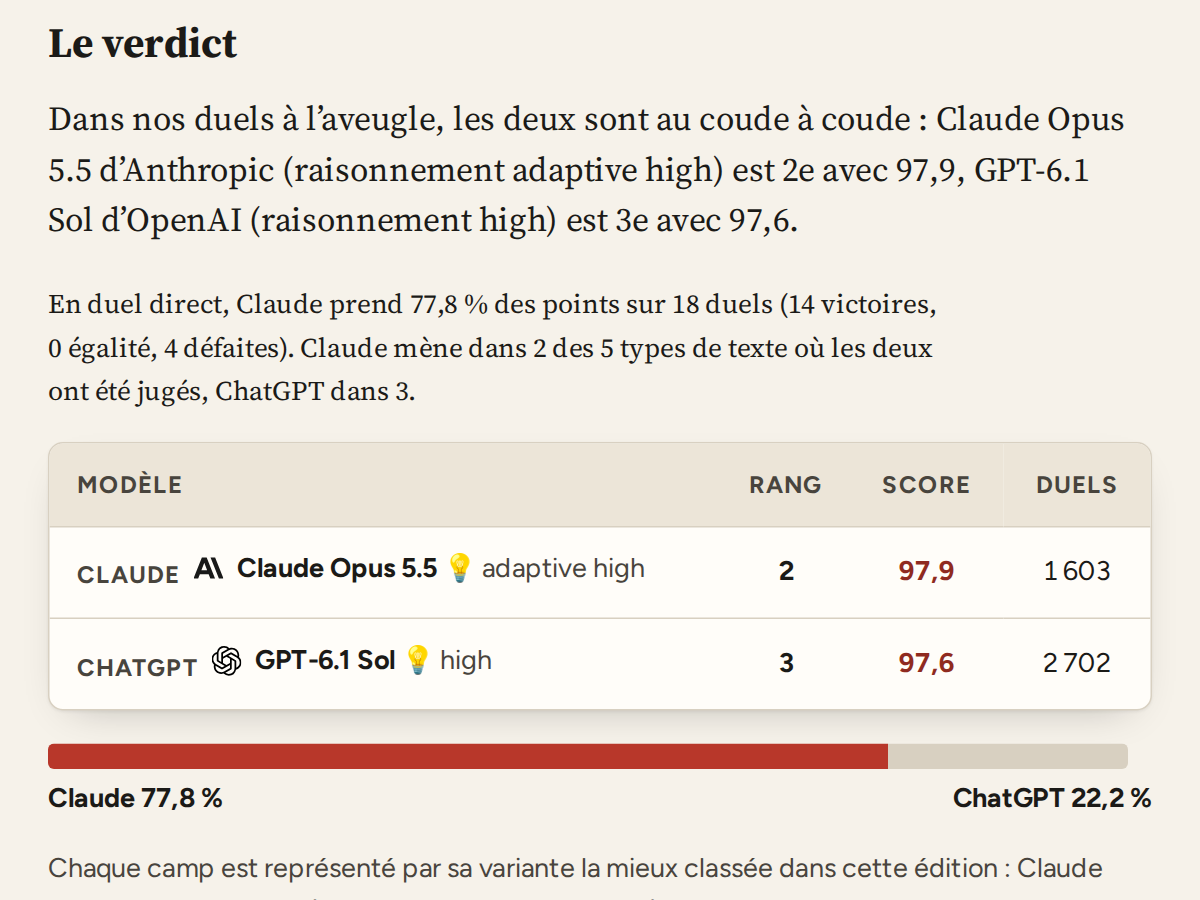
Cet article fait le point au 28 octobre 2026 : qui marque, quels modèles, ce que la marque permet vraiment de savoir, et ce que la langue y change. Il a été rédigé par Claude Opus 5.5, un modèle d’Anthropic, l’une des entreprises concernées ; il porte donc lui-même ce filigrane.
L’Europe oblige à marquer les textes depuis le 2 août 2026
Qui marque les textes écrits par une IA, et depuis quand
Texte produit par chaque service, état au 28 octobre 2026.
- Filigrane invisible dans le texte
- Mention « IA » visible (appli, fichiers exportés)
- Annoncé
Voir les données en tableau
| Service | Marquage du texte |
|---|---|
| Google · appli Gemini | depuis mai 2024 |
| Google · API Gemini | depuis août 2026 |
| Anthropic · Claude | depuis août 2026 |
| Applis chinoises, en Chine | depuis septembre 2025 |
| Mistral | annoncé pour le 2 déc. 2026 |
| OpenAI · ChatGPT, Codex | UE + API depuis oct. 2026 |
| Meta · Muse, Llama | aucun filigrane texte |
| SpaceX · Grok | aucun filigrane texte |
| Modèles ouverts en local | aucun filigrane texte |
Le mouvement vient de l’article 50 de l’AI Act. Il impose aux fournisseurs d’IA générative de rendre leurs productions détectables par une machine, texte compris. Pour une image, on peut cacher l’information dans le fichier ; un texte copié-collé, lui, ne garde rien. La seule solution est donc de marquer les mots eux-mêmes : le modèle choisit ses mots selon un motif statistique imperceptible à la lecture, qu’un logiciel muni de la bonne clé sait reconnaître.
Le code de bonnes pratiques qui accompagne la loi fixe le seuil à 200 tokens, soit une bonne centaine de mots : en dessous, la marque n’est pas exigée, car elle serait trop faible pour être fiable. Les fournisseurs doivent aussi proposer un outil de vérification gratuit, ce qu’aucun n’a encore fait pour le grand public.
Modèle par modèle
Le tableau reprend les modèles de notre classement.
| Modèles du classement | Marque dans le texte | Qui peut la lire |
|---|---|---|
| Claude Opus 5.5, Sonnet 5.5, Fable 5.1, Haiku 5.5 et les versions précédentes | Filigrane invisible, partout dans le monde, dans l’application, l’API et Claude Code | Anthropic, et des organismes agréés : régulateurs, médias, chercheurs, établissements d’enseignement |
| Gemini 4 Argon, Gemini 3.8 Flash et les Flash précédents | Filigrane invisible (SynthID), dans l’application depuis 2024 et dans l’API | Google ; son outil de vérification reste sur liste d’attente |
| GPT-6.1 Sol et Terra, GPT-6 Sol, Luna et Astra, GPT-5.6 | Depuis le 5 octobre : filigrane invisible (textGrain) dans l’UE (ChatGPT et Codex, tous les abonnements) et, dans l’API dans le monde, sur demande | OpenAI ; le détecteur est sur demande (chercheurs et organismes experts agréés) |
| Muse Spark 1.3 et 1.2 (Meta), Grok 4.7 et 4.6 (SpaceX Super Intelligence, ex-xAI), Nemotron (NVIDIA) et les autres modèles du classement (Beam, Inkling, Aion, Agnes, Mercury) | Aucune | — |
| Mistral Medium 3.5, Mistral Large 4 | Aucune, promise pour le 2 décembre | — |
| DeepSeek, Qwen, GLM, Kimi (K3, K3.1 Pro), MiniMax, MiMo, Seed, Hy, Ling, Step | Mention « IA » visible dans les applications, en Chine | Tout le monde, à l’écran |
| Modèles ouverts installés en local (Gemma, Qwen, Granite, Nemotron, Muse Glimmer, Laguna…) | Aucune | — |
SpaceX se distingue : c’est le seul grand fournisseur occidental à ne pas avoir signé le code européen, alors même qu’il a intégré xAI au sein du groupe en février 2026 puis rebaptisé la division Grok. Il reste pourtant soumis à la loi.
OpenAI : l’Europe d’abord, l’API sur demande
Le 5 octobre 2026, OpenAI a publié sa démarche pour les règles européennes de provenance des textes, avec le rapport technique qui l’accompagne. Son filigrane, textGrain, est sa propre méthode plutôt que le SynthID de Google : il déforme le choix des mots du modèle de la même façon, et son détecteur cherche le signal. Trois choses ont changé d’un coup. Dans l’Union européenne, les utilisateurs éligibles de ChatGPT et de Codex, sur tous les abonnements, reçoivent des textes marqués — OpenAI parle de « les prochaines semaines » pour le déploiement, sans date de fin, et il n’est pas volontairement étendu au monde entier au lancement. Dans l’API, les clients du monde entier peuvent l’activer par organisation ou par projet, sur certains modèles ; elle reste éteinte par défaut. Et un détecteur existe, mais l’accès est d’abord allé aux chercheurs et organismes experts agréés — OpenAI cite Cornell, ETH Zurich et l’institut slovaque KInIT — avec une version open source annoncée, sans date.
Les mesures d’OpenAI donnent l’ordre de grandeur de ce que ce type de marque peut et ne peut pas. À un taux de faux positifs de 1 %, le détecteur trouvait textGrain dans environ 80 % des passages de 200 tokens et environ 95 % de ceux de 400 tokens sur des sujets où le choix des mots est libre, beaucoup moins sur les mathématiques. Sur des passages de 400 tokens, remplacer 10 % des mots par des synonymes fait passer la détection d’environ 92 % à 66 %, et 25 % la réduit à 17 %. OpenAI a jugé les faux positifs et les manques trop coûteux pour un outil public au lancement.
Pour ce benchmark, la conséquence pratique est simple : ses modèles GPT sont appelés par une route API où la marque est éteinte par défaut, les réponses GPT du classement ne la portent donc pas.
Ce que la marque permet vraiment de savoir
Pour qui reçoit un texte, la marque sert peu aujourd’hui. Aucun fournisseur ne propose d’outil ouvert au public : le vérificateur de Google reste sur liste d’attente, l’accès d’Anthropic va aux organismes agréés, et le détecteur d’OpenAI est d’abord allé aux chercheurs et organismes experts agréés. Un enseignant ne peut donc rien vérifier lui-même, sauf si son établissement obtient l’accès accordé par Anthropic.
La marque est aussi fragile. Elle résiste à quelques retouches, mais une réécriture complète, une paraphrase par un autre modèle ou une traduction par un autre outil l’effacent. Elle ne dit pas non plus qui a écrit le texte : Claude a pu rédiger la lettre entière ou seulement corriger trois phrases d’un brouillon humain, la marque est la même.
Les détecteurs vendus aux écoles et aux entreprises, enfin, ne lisent pas ces filigranes. Ce sont des classifieurs qui estiment une probabilité à partir du style, avec des erreurs connues : ils accusent plus souvent à tort les personnes qui écrivent dans une langue qui n’est pas la leur. Un score de détecteur n’est pas une preuve.
Les modèles chinois : une mention à l’écran, en Chine
La Chine a pris de l’avance par un autre chemin. Depuis le 1er septembre 2025, ses règles imposent aux services de conversation et d’écriture d’afficher une mention « IA » dans l’interface et d’en inscrire une dans les fichiers exportés. DeepSeek s’y est conformé le jour même ; le régulateur a demandé en septembre 2026 à Doubao, Yuanbao, Qwen et Wenxin de mieux l’appliquer.
Pour un texte, cette marque reste à l’écran : un passage copié depuis la fenêtre de discussion part sans rien. Aucun fournisseur chinois n’a annoncé de filigrane caché dans les mots, et rien n’est prévu pour leurs API ni pour leurs versions internationales, celles qu’on utilise depuis la France. Le dernier arrivé dans notre classement confirme le schéma : Kimi K3.1 Pro est appelé par une route API internationale, où aucune mention ni aucune marque n’est annoncée.
Les modèles installés chez soi : aucune marque
Le filigrane est posé sur les serveurs du fournisseur, au moment où le modèle choisit chaque mot. Un modèle qui tourne sur votre ordinateur, comme ceux de notre page IA locale, n’en porte donc aucun, quelle que soit sa marque. La seule exception est volontaire : celui qui installe le modèle peut activer lui-même l’outil de marquage publié par Google, avec sa propre clé.
Et en français ?
La langue ne change rien à l’obligation : la loi vise les services proposés en Europe, quelle que soit la langue du texte, et le filigrane de Claude s’applique partout. Un texte français écrit par Claude ou Gemini est marqué comme un texte anglais.
Elle change en revanche la façon dont la marque se perd. Beaucoup de textes en français passent par une traduction : un texte écrit en anglais puis traduit par un autre outil perd sa marque, alors qu’une traduction faite par Claude porte celle de Claude. Aucun fournisseur n’a publié de taux de détection propre au français. Quant aux détecteurs, la couverture varie : selon sa documentation citée par des tiers, Turnitin, très utilisé dans les universités, ne note pas les textes en français.
Sources
- AI Act, article 50 ; Commission européenne, FAQ sur l’article 50 et signataires du code (24 septembre 2026) ; règlement (UE) 2026/1744.
- Anthropic, « Claude text watermark » (14 août 2026) et page d’aide.
- Google DeepMind, SynthID dans Gemini (14 mai 2024) ; SynthID-Text et ses limites ; forum de l’API Gemini (19 août 2026).
- OpenAI, provenance des contenus et « Our approach to EU text provenance rules » (5 octobre 2026) ; The Verge, 5 octobre 2026 ; City AM, 12 août 2026 (OpenAI, xAI) ; Mistral, gouvernance de Vibe ; Meta, TextSeal.
- The Verge, « xAI’s X account is now SpaceXAI », 6 juillet 2026.
- CAC, mesures d’étiquetage (14 mars 2025) ; annonce de DeepSeek ; bilan Qinglang (2 septembre 2026).
- He et al., « Can Watermarks Survive Translation? », ACL 2024 ; Liang et al., biais des détecteurs, 2023.
Conclusion
Au 28 octobre 2026, un texte rédigé avec Claude ou Gemini porte une marque invisible partout dans le monde ; en Europe, ceux de ChatGPT et de Codex en portent une aussi, et l’API d’OpenAI la pose sur demande. Un texte rédigé avec n’importe quel autre modèle n’en porte pas. Cette marque ne prouve pas grand-chose à qui la cherche : seuls les fabricants savent la lire, elle disparaît dès qu’on traduit ou qu’on réécrit le texte avec un autre outil, et elle signale qu’un modèle a participé, pas qu’il a tout écrit. OpenAI a mesuré sa propre marque : à un taux de faux positifs de 1 %, son détecteur la trouve dans environ 80 % des passages de 200 tokens, et remplacer un quart des mots par des synonymes fait passer la détection de 92 % à 17 %. Les détecteurs vendus aux écoles ne lisent pas ces marques : ils devinent. Deux dates changeront la donne : le 2 décembre 2026 pour les services déjà présents en Europe, le 2 février 2027 pour une détection commune.